SW Guide pas-à-pas - Laboratoire Swarm · version Docker-in-Docker

L'essaim : WordPress répliqué
sur un cluster, sans machine virtuelle

Cinq noeuds qui agissent comme une seule machine, un proxy inverse qui route le trafic, et le site de Cornucopia qui se réplique. Ici, les cinq noeuds sont des conteneurs sur votre propre Linux : rien à installer, rien à cloner. Six étapes guidées : NOEUDS, ESSAIM, PROXY, SAUVEGARDE, SERVICES, VISUALISEUR.

Ce qu'on vous fournit

La sauvegarde complète du site en ligne cornucopia.projet.autos, la ferme de Flora et Hazel, en un seul fichier : sauvegarde-cornucopia-formation.zip (39 Mo). Il contient :

Comptes du tableau de bord pour ce laboratoire : agence, flora et hazel, tous avec le mot de passe cornucopia-2026. Base de données cornucopia, compte flora, mot de passe potager-2026, mot de passe root racine-potager-2026 : ce sont les valeurs que le wp-config.php de la sauvegarde attend. Les mots de passe ont été réinitialisés pour le laboratoire : ce ne sont pas ceux du site en production.

Les deux piles complètes, reproduites dans ce guide et téléchargeables : traefik.yml (étape 03) et wordpress-sticky.yml (étape 05). Cinq images de Docker Hub : docker:dind (le noeud lui-même), traefik:1.7, wordpress (figée en version 7.1), mysql:8.0 et dockersamples/visualizer. Rien à construire cette semaine.

Le plan d'adressage des cinq noeuds, le même que dans la version machines virtuelles : swarm-node01 192.168.56.10 (gestionnaire et chef), swarm-node02 .20 et swarm-node03 .30 (gestionnaires), swarm-node04 .40 (travailleur, porte la base de données) et swarm-node05 .50 (travailleur).

Vous produirez : vos cinq noeuds configurés, les deux piles déployées, le site existant qui revit sur l'essaim, le visualiseur, et votre README.md avec le journal des commandes. Dans votre dépôt Git, le dossier swarm/ contient traefik.yml, wordpress-sticky.yml et README.md.

Avant de commencer

Pré-requis

Le mode d'emploi de ce guide

Deux invites : votre Linux et le noeud

Chaque noeud est un conteneur qui fait tourner son propre Docker. On y entre avec docker exec, on en sort avec exit. Dans les consoles de ce guide, l'invite $ veut dire « sur votre Linux » et l'invite # veut dire « à l'intérieur du noeud nommé dans le titre de la console ».

Votre Linux, puis swarm-node01 - entrer dans un noeud, en sortir
$ docker exec -it swarm-node01 sh
# hostname
swarm-node01
# docker ps
# le Docker DU NOEUD : sa propre liste, vide pour l'instant
# exit
$
# le raccourci : une seule commande dans le noeud, sans y entrer
$ docker exec swarm-node01 docker ps
Pas de sudo dans un noeud. Dans un noeud vous êtes root : les commandes docker s'écrivent sans sudo, et sudo n'y existe d'ailleurs pas. Sur votre Linux, si votre compte n'est pas dans le groupe docker, préfixez sudo devant chaque commande $ de ce guide.

Vue d'ensemble

Le parcours en six étapes

La grande idée : déclarer un état désiré et laisser l'essaim le maintenir. Trois gestionnaires qui peuvent tous devenir chef, deux travailleurs qui portent WordPress, un proxy inverse Traefik qui route le trafic, et le site de Cornucopia, avec ses données, qui renaît répliqué : votre première architecture distribuée. Les noeuds sont des conteneurs, mais l'essaim ne le sait pas : tout ce qui suit l'étape 01 est identique sur des machines virtuelles ou des VPS.

Étape 01 · Noeuds

Cinq conteneurs Docker-in-Docker

Étape 02 · Essaim

init, join et les jetons

Étape 03 · Proxy

Le réseau overlay et Traefik

Étape 04 · Sauvegarde

Le site existant sur les travailleurs

Étape 05 · Services

Répliquer le site Cornucopia

Étape 06 · Visualiseur

Voir l'essaim en direct

01

Créer les noeuds : cinq conteneurs Docker-in-Docker qui se connaissent

Noeuds

Créer cinq noeuds nommés swarm-node01 à swarm-node05, aux adresses 192.168.56.10 à .50, sur un réseau Docker privé. Chaque noeud est un conteneur docker:dind : un démon Docker complet, avec son nom d'hôte et son adresse, comme une petite machine.

Pour mieux comprendre

DinD, c'est Docker in Docker. L'image officielle docker:dind contient un démon Docker entier. Lancée en mode privilégié, elle devient un serveur à part entière : son propre Docker, ses propres images, ses propres conteneurs, isolé des autres noeuds. Le réseau reseau-swarm joue le rôle du réseau privé hôte de la version VirtualBox : Docker y attribue les adresses fixes qu'on lui demande et fait office de DNS entre les noeuds. D'où deux étapes en moins par rapport aux machines virtuelles : pas de fichier /etc/hosts à recopier, pas de netplan.

Démarche - le réseau des noeuds

Votre Linux - le réseau
$ docker network create --subnet 192.168.56.0/24 reseau-swarm
8c75eaf84d1c1e6f9a2b7c3d4e5f60718293a4b5c6d7e8f9a0b1c2d3e4f5a6b7
$ docker network ls
NETWORK ID     NAME           DRIVER    SCOPE
5b2d02772b63   bridge         bridge    local
8c75eaf84d1c   reseau-swarm   bridge    local

Démarche - les cinq noeuds

Cinq fois la même commande, seuls le nom et l'adresse changent. La barre oblique inversée en fin de ligne continue la commande sur la ligne suivante : recopiez les trois lignes d'un bloc.

Votre Linux - les cinq noeuds
$ docker run -d --privileged --name swarm-node01 --hostname swarm-node01 \
    --network reseau-swarm --ip 192.168.56.10 \
    -e DOCKER_TLS_CERTDIR="" -e DOCKER_MIN_API_VERSION=1.24 docker:dind
$ docker run -d --privileged --name swarm-node02 --hostname swarm-node02 \
    --network reseau-swarm --ip 192.168.56.20 \
    -e DOCKER_TLS_CERTDIR="" -e DOCKER_MIN_API_VERSION=1.24 docker:dind
$ docker run -d --privileged --name swarm-node03 --hostname swarm-node03 \
    --network reseau-swarm --ip 192.168.56.30 \
    -e DOCKER_TLS_CERTDIR="" -e DOCKER_MIN_API_VERSION=1.24 docker:dind
$ docker run -d --privileged --name swarm-node04 --hostname swarm-node04 \
    --network reseau-swarm --ip 192.168.56.40 \
    -e DOCKER_TLS_CERTDIR="" -e DOCKER_MIN_API_VERSION=1.24 docker:dind
$ docker run -d --privileged --name swarm-node05 --hostname swarm-node05 \
    --network reseau-swarm --ip 192.168.56.50 \
    -e DOCKER_TLS_CERTDIR="" -e DOCKER_MIN_API_VERSION=1.24 docker:dind
$ docker ps
CONTAINER ID   IMAGE         COMMAND                  STATUS         NAMES
8aa9a30376fd   docker:dind   "dockerd-entrypoint.…"   Up 2 minutes   swarm-node05
1a48fcc99986   docker:dind   "dockerd-entrypoint.…"   Up 2 minutes   swarm-node04
d726a11f5eae   docker:dind   "dockerd-entrypoint.…"   Up 2 minutes   swarm-node03
43ee9f94769d   docker:dind   "dockerd-entrypoint.…"   Up 2 minutes   swarm-node02
ebc9004badb4   docker:dind   "dockerd-entrypoint.…"   Up 2 minutes   swarm-node01

Ce que dit la commande

  • -d : en arrière-plan, comme au laboratoire Docker.
  • --privileged : le démon Docker du noeud a besoin des droits complets sur le noyau (réseaux, montages). C'est la seule raison d'être de cette option ici : un noeud dind ne se lance pas sans elle.
  • --name swarm-node01 --hostname swarm-node01 : le nom du conteneur vu de votre Linux, et le nom d'hôte vu de l'intérieur. Les deux identiques : c'est le nom qu'affichera docker node ls et que la pile utilisera dans sa contrainte de placement (node.hostname == swarm-node04).
  • --network reseau-swarm --ip 192.168.56.10 : le réseau privé des noeuds, et l'adresse fixe du noeud dans ce réseau. Sans --ip, Docker attribuerait la première adresse libre, et le plan d'adressage du laboratoire ne tiendrait plus.
  • -e DOCKER_TLS_CERTDIR="" : le Docker du noeud écoute sans certificats TLS. Rien à sécuriser entre vous et vous-même.
  • -e DOCKER_MIN_API_VERSION=1.24 : l'image traefik:1.7 du laboratoire parle une version ancienne de l'API Docker (1.24) que les démons récents refusent par défaut (minimum 1.40). Cette variable rouvre la porte. Sans elle, Traefik ne verra jamais vos services : erreur « client version 1.24 is too old ».
  • docker:dind : l'image officielle Docker-in-Docker, celle qui fait de ce conteneur un noeud.

Démarche - le noeud se présente

Votre Linux, puis swarm-node01 - vérifier un noeud
$ docker exec -it swarm-node01 sh
# hostname
swarm-node01
# ip -4 -o addr show eth0
26: eth0    inet 192.168.56.10/24 brd 192.168.56.255 scope global eth0
# docker info | grep -E "Name|Server Version"
 Server Version: 29.7.2
 Name: swarm-node01
# ping -c 1 swarm-node05
1 packets transmitted, 1 packets received, 0% packet loss
# docker compose version
Docker Compose version v5.4.0
# exit
Éteindre et rallumer l'essaim. Tout ce que vous ferez dans ce laboratoire (l'essaim, les images, les fichiers du site, la base de données) vit à l'intérieur des cinq conteneurs. docker stop swarm-node01 swarm-node02 swarm-node03 swarm-node04 swarm-node05 éteint les cinq noeuds; docker start avec les mêmes noms les rallume, et l'essaim se reforme tout seul, en quelques minutes. Après un redémarrage de votre ordinateur, les noeuds sont arrêtés : un docker start suffit. En revanche, docker rm détruit un noeud avec tout son contenu : c'est votre incendie volontaire à vous, gardez-le pour l'exprès.
Ce laboratoire exige le Docker classique, celui du service système. En mode rootless (vu au laboratoire Docker), le mode privilégié et l'accès aux adresses 192.168.56.x depuis votre navigateur ne sont pas garantis. Vérifiez avec docker info | grep -i rootless : la réponse doit être vide. Si votre terminal pointe vers le démon rootless, revenez au démon système le temps de la séance : unset DOCKER_HOST puis docker context use default. Autre conflit possible : si VirtualBox est installé avec son réseau privé hôte en 192.168.56.0/24, les deux réseaux se disputent la même route. Désactivez celui de VirtualBox (Fichier, Outils, Gestionnaire de réseau) ou choisissez un autre sous-réseau, partout dans ce guide.
docker ps sur votre Linux montre les cinq noeuds Up. Depuis swarm-node01, ping swarm-node05 répond : les noeuds se trouvent par leur nom. Dans chaque noeud, docker compose version répond aussi. Cinq serveurs prêts, en deux minutes.
02

Monter l'essaim : init, les jetons, join

Essaim

Initialiser le cluster sur le premier noeud, puis y joindre deux autres gestionnaires (haute disponibilité du cerveau) et deux travailleurs (les bras qui porteront WordPress).

Pour mieux comprendre

docker swarm init génère deux jetons : un jeton de travailleur et un jeton de gestionnaire. Le jeton utilisé au join décide du rôle du noeud. Trois gestionnaires : le cluster survit à la perte de l'un d'eux, chacun pouvant devenir chef. Le premier noeud devient gestionnaire et chef (Leader); les deux autres gestionnaires sont Reachable, prêts à prendre le relais. Swarm gère ensuite le cluster comme une seule et unique machine Docker.

Démarche - initialiser

swarm-node01 - initialiser l'essaim
$ docker exec -it swarm-node01 sh
# docker swarm init --advertise-addr 192.168.56.10
Swarm initialized: current node (w9a1fcq23p3lyc32or0pwqng9) is now a manager.

To add a worker to this swarm, run the following command:

    docker swarm join --token SWMTKN-1-4kbutkut8q0l82cnq6u9wl8m4iq3s3q9ptoda8xxtx3p9eyism-bf8mb87165bgftatvwifguaex 192.168.56.10:2377

To add a manager to this swarm, run 'docker swarm join-token manager' and follow the instructions.
# le jeton affiché ici est celui des TRAVAILLEURS : gardez-le pour swarm-node04 et 05
# docker swarm join-token manager
To add a manager to this swarm, run the following command:

    docker swarm join --token SWMTKN-1-4kbutkut8q0l82cnq6u9wl8m4iq3s3q9ptoda8xxtx3p9eyism-3gy8clp83dyueds2zjgsk0jaf 192.168.56.10:2377
# celui-ci est le jeton des GESTIONNAIRES : pour swarm-node02 et 03
# exit

Les jetons ci-dessus sont ceux d'un exemple : les vôtres seront différents, recopiez-les depuis votre propre sortie. docker swarm join-token worker réaffiche celui des travailleurs en cas de besoin.

Démarche - rejoindre

Les quatre autres noeuds - rejoindre l'essaim
# swarm-node02 et 03 : avec le jeton de GESTIONNAIRE
$ docker exec -it swarm-node02 sh
# docker swarm join --token JETON-MANAGER 192.168.56.10:2377
This node joined a swarm as a manager.
# exit
# même chose dans swarm-node03

# swarm-node04 et 05 : avec le jeton de TRAVAILLEUR (celui du init)
$ docker exec -it swarm-node04 sh
# docker swarm join --token JETON-WORKER 192.168.56.10:2377
This node joined a swarm as a worker.
# exit
# même chose dans swarm-node05
swarm-node01 - les cinq noeuds
$ docker exec swarm-node01 docker node ls
ID                            HOSTNAME       STATUS    AVAILABILITY   MANAGER STATUS   ENGINE VERSION
w9a1fcq23p3lyc32or0pwqng9 *   swarm-node01   Ready     Active         Leader           29.7.2
tbb9j92t7yba1v2a9smaa100d     swarm-node02   Ready     Active         Reachable        29.7.2
oe9kp5k249kqm7dn7ms88g60t     swarm-node03   Ready     Active         Reachable        29.7.2
mqnow406srujxivzm6mb50a9t     swarm-node04   Ready     Active                          29.7.2
xxkpt4t6brxcb694do37g90re     swarm-node05   Ready     Active                          29.7.2
Deux jetons différents pour deux rôles différents : joindre un noeud avec le mauvais jeton lui donne le mauvais rôle. Ici chaque noeud n'a qu'une adresse, mais gardez l'habitude du --advertise-addr : sur une machine à plusieurs interfaces (une VM avec carte NAT et réseau privé hôte, un VPS), il est indispensable. Les commandes de gestion (node ls, stack deploy, service ls) ne fonctionnent que sur un gestionnaire.
Sur un gestionnaire, docker node ls montre les cinq noeuds : trois avec un statut de gestionnaire (Leader ou Reachable), deux travailleurs, tous Ready. Vous avez désormais un cluster Swarm opérationnel et prêt à recevoir vos conteneurs.
03

Le réseau et le proxy : overlay et Traefik

Proxy

Créer le réseau overlay qui relie les services d'un noeud à l'autre, puis déployer la première pile : Traefik, le proxy inverse qui routera le trafic vers WordPress et gardera les sessions persistantes.

Pour mieux comprendre

Une pile (stack) est une partition Compose que l'essaim déploie : mêmes services, mêmes réseaux, plus une section deploy qui dit combien de répliques et sur quels noeuds. Le réseau overlay est le réseau multi-hôtes de l'essaim : deux services placés sur deux machines différentes s'y parlent comme s'ils étaient voisins, et se trouvent par leur nom.

Démarche - écrire la pile sur votre Linux

Votre Linux - le dossier de la remise et le fichier de la pile
$ mkdir -p ~/swarm
$ cd ~/swarm
$ nano traefik.yml
# ou, avec votre éditeur habituel (kate...), ou en le téléchargeant :
$ wget https://evolutif.projet.autos/laboratoire/conteneurs/swarm/guide-dind/traefik.yml

La pile à écrire, telle quelle : rien à compléter, ce sont les valeurs du diaporama. Le service s'appelle loadbalancer; la pile, elle, s'appellera traefik au déploiement.

traefik.yml - la pile
version: '3.2'

services:
  loadbalancer:
    image: traefik:1.7
    command: --docker \
      --docker.swarmmode \
      --docker.watch \
      --web \
      --loglevel=DEBUG
    ports:
      - 80:80
      - 9090:8080
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    deploy:
      restart_policy:
        condition: any
      mode: replicated
      replicas: 1
      update_config:
        delay: 2s
      placement:
        constraints: [node.role == manager]
    networks:
      - net

networks:
  net:
    external: true

Ce que dit le fichier traefik.yml

  • command: : --docker --docker.swarmmode : Traefik découvre tout seul les services de l'essaim; --docker.watch : il suit leurs changements en direct; --web : son tableau de bord, sur son port 8080; --loglevel=DEBUG : bavard, pour apprendre.
  • ports: : 80 (le trafic des visiteurs) et 9090 (le tableau de bord, relié au 8080 interne).
  • volumes: /var/run/docker.sock : la fenêtre de Traefik sur l'essaim. C'est par cette socket qu'il lit l'état des services, et c'est pourquoi il doit tourner sur un gestionnaire.
  • deploy: : la section qui n'existait pas en Compose : politique de redémarrage (any), mode répliqué, une réplique, mise à jour avec 2 s de délai.
  • placement: constraints: [node.role == manager] : Traefik est ancré sur un gestionnaire : votre première contrainte de placement.
  • networks: net: external: true : la pile rejoint le réseau overlay créé à la main, elle ne le crée pas.

Démarche - envoyer le fichier au noeud et déployer

Votre Linux, puis swarm-node01 - le réseau overlay et la pile
$ docker exec swarm-node01 mkdir -p /home/docker/swarm
$ docker cp traefik.yml swarm-node01:/home/docker/swarm/traefik.yml
$ docker exec -it swarm-node01 sh
# docker network create -d overlay net
0h3ndtxaoz1tvsrj64q3h8scz
# docker stack deploy --compose-file=/home/docker/swarm/traefik.yml traefik
Since --detach=false was not specified, tasks will be created in the background.
In a future release, --detach=false will become the default.
Creating service traefik_loadbalancer
# les deux lignes sur --detach sont un avertissement sans conséquence
# docker service ls
ID             NAME                   MODE         REPLICAS   IMAGE         PORTS
ilf1r38kh2j8   traefik_loadbalancer   replicated   1/1        traefik:1.7   *:80->80/tcp, *:9090->8080/tcp
# en cas de besoin, la pile se retire d'une commande :
# docker stack rm traefik
Le fichier s'écrit chez vous, il voyage par docker cp. Un noeud Docker-in-Docker est une image Alpine minimale : pas de nano. Plutôt que d'éditer à l'aveugle dans le noeud, vous écrivez la pile sur votre Linux, avec votre éditeur, dans ~/swarm, et docker cp la dépose au bon chemin du noeud. Bonus : ~/swarm est exactement le dossier swarm/ de votre remise Git. Vos livrables se construisent tout seuls, au fil du laboratoire.
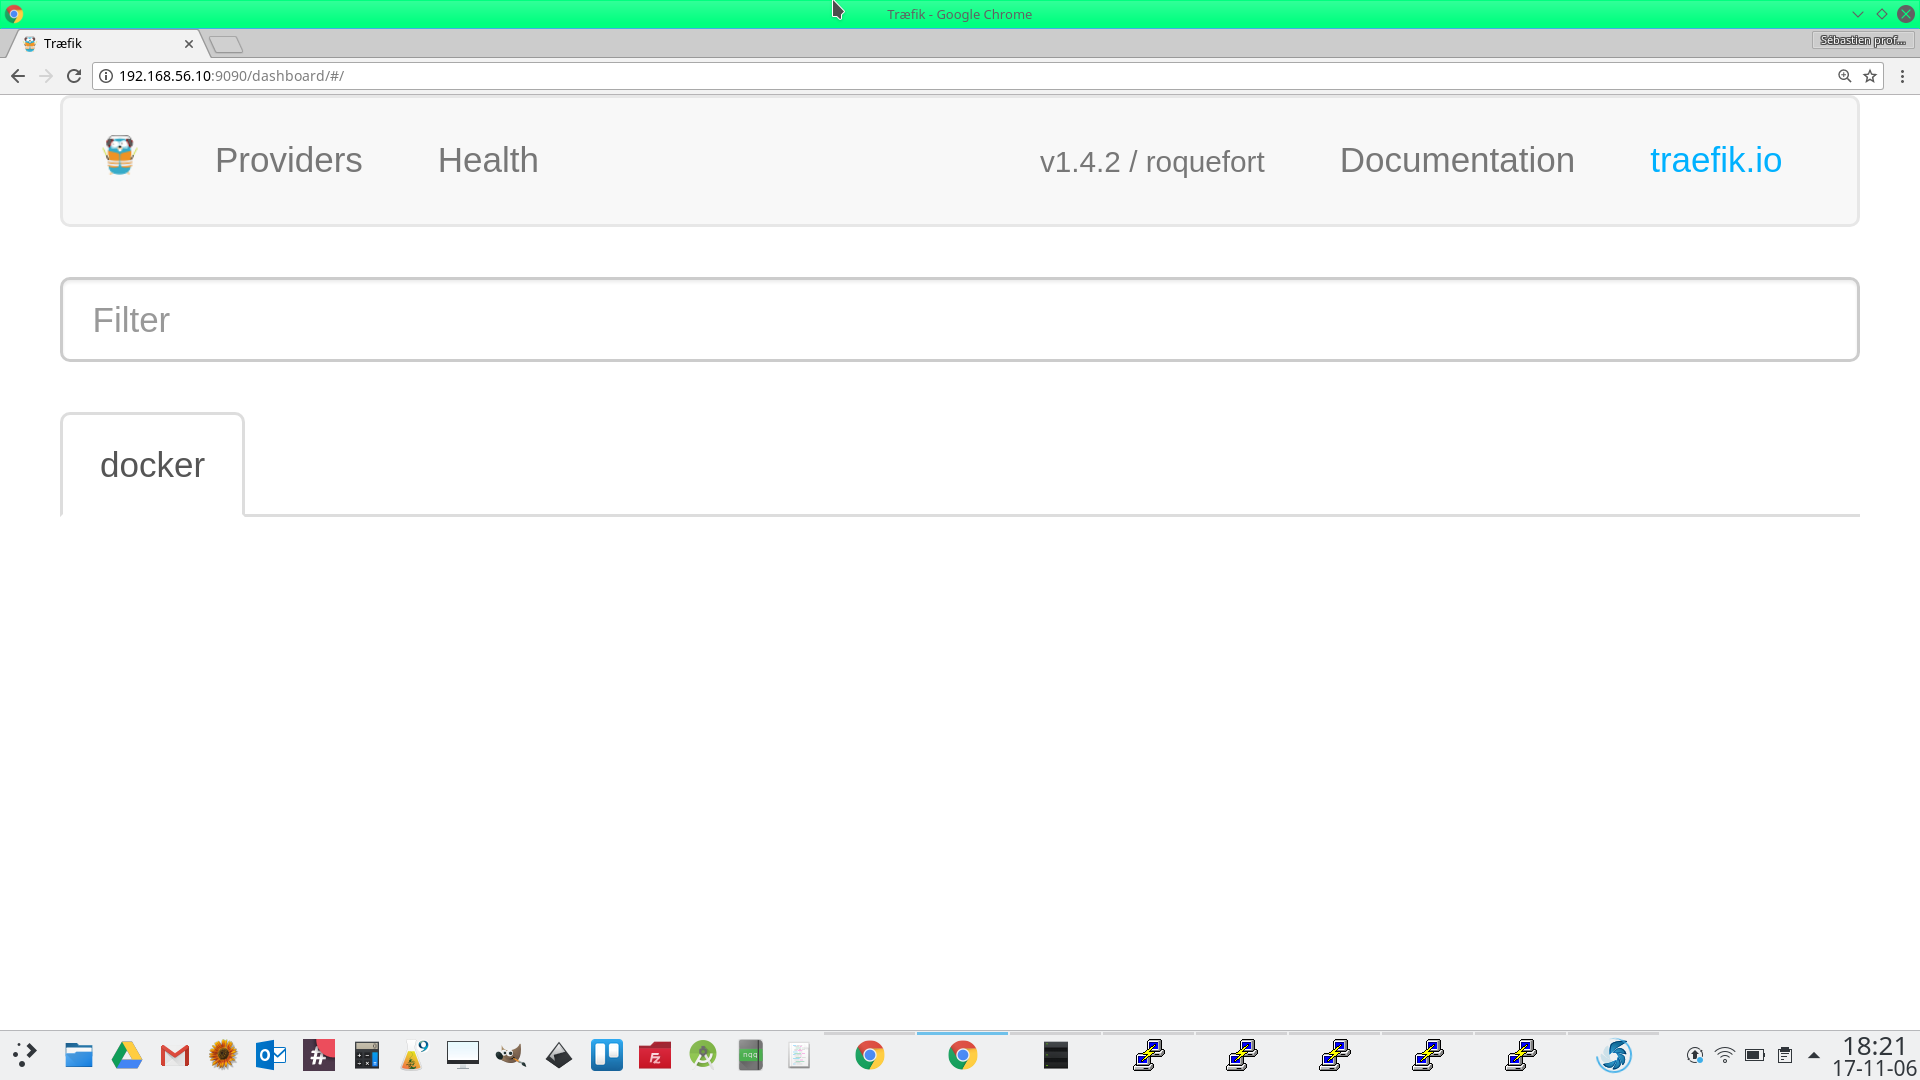
Le tableau de bord Traefik sur http://192.168.56.10:9090 : en fonction, mais encore vide, aucun service WordPress ne lui est présenté.
Après une ou deux minutes, le tableau de bord Traefik répond sur http://192.168.56.10:9090 dans le navigateur de votre Linux, et service ls montre traefik_loadbalancer en 1/1.
04

Récupérer le site existant : la sauvegarde sur les travailleurs

Sauvegarde

Déposer la sauvegarde de Cornucopia sur les deux travailleurs, au même chemin, puis faire les deux ajustements déjà vus au laboratoire Compose : la base de données vers le service db, et le repointage de l'adresse dans l'export.

Pour mieux comprendre

On ne repart pas d'un site vide : la sauvegarde complète de la ferme (fichiers et base de données) reprend vie sur le cluster, comme aux laboratoires Docker et Compose. L'image wordpress:7.1 repart à neuf, mais le site et sa base de données sont ceux de Flora : rien ne disparaît.

Le problème que cette étape résout. Au laboratoire Compose, tout se passait sur une seule machine : le zip déballé à côté de la partition, et les répertoires partagés qui pointent dessus. Dans l'essaim, la pile est déployée depuis swarm-node01, mais les conteneurs WordPress tourneront sur swarm-node04 et 05, et la base sur swarm-node04. Or l'essaim ne copie jamais un fichier d'un noeud à l'autre. Un répertoire partagé dans une pile veut dire « ce chemin, sur le noeud où la tâche atterrit ». Si les fichiers n'y sont pas, WordPress démarre sur un répertoire vide et l'image installe un site vierge. Nos noeuds sont des conteneurs, mais la règle est la même : chacun a son propre disque. D'où cette étape à part, avant la pile : on prépare le terrain sur les travailleurs, puis on décrit et on déploie depuis le gestionnaire.

Les trois gestes, et sur quels noeuds

  • Déballer le zip sur les deux travailleurs, swarm-node04 et swarm-node05, au même chemin /home/docker/swarm/sauvegarde. Le zip y arrive par docker cp.
  • Changer une ligne de wp-config.php, sur les deux travailleurs aussi : DB_HOST devient db:3306.
  • Le repointage de l'adresse, à la fin de l'export, sur swarm-node04 seulement.
  • Et un quatrième, petit mais sans lequel rien ne démarre : créer le répertoire de la base, /home/docker/swarm/database, vide, sur swarm-node04 seulement.

Démarche - le zip vers les deux travailleurs

Votre Linux - télécharger une fois, déposer deux fois
$ cd ~
# pas dans ~/swarm : le zip de 39 Mo n'a rien à faire dans votre dépôt Git
$ wget https://evolutif.projet.autos/laboratoire/conteneurs/swarm/guide/sauvegarde-cornucopia-formation.zip
$ docker exec swarm-node04 mkdir -p /home/docker/swarm
$ docker exec swarm-node05 mkdir -p /home/docker/swarm
$ docker cp sauvegarde-cornucopia-formation.zip swarm-node04:/home/docker/swarm/
$ docker cp sauvegarde-cornucopia-formation.zip swarm-node05:/home/docker/swarm/

Démarche - la sauvegarde sur chaque travailleur

swarm-node04 ET swarm-node05 - déballer la sauvegarde
$ docker exec -it swarm-node04 sh
# cd /home/docker/swarm
# unzip -q sauvegarde-cornucopia-formation.zip -d sauvegarde
# ls sauvegarde
README.md            base-de-donnees.sql  fichiers-wordpress
# chown -R 33:33 sauvegarde/fichiers-wordpress
# Apache, dans les conteneurs WordPress, doit pouvoir écrire : 33 est le numéro de www-data
# sed -i "s/'localhost'/'db:3306'/" sauvegarde/fichiers-wordpress/wp-config.php
# grep DB_HOST sauvegarde/fichiers-wordpress/wp-config.php
define( 'DB_HOST', 'db:3306' );
# exit
$ docker exec -it swarm-node05 sh
# ... et les mêmes commandes, à l'identique, dans swarm-node05

Les deux travailleurs, parce que la contrainte de placement de la pile dira « n'importe quel travailleur » : une réplique WordPress peut atterrir sur l'un ou sur l'autre, et chacun doit trouver le site au même chemin.

Pourquoi 33 et pas www-data. Le noeud est une Alpine minimale : l'utilisateur www-data n'y existe pas, chown www-data répondrait « unknown user ». Mais le conteneur WordPress qui montera ces fichiers est une image Debian, où Apache tourne sous www-data, numéro 33. Linux ne stocke que des numéros dans les fichiers, jamais des noms : chown -R 33:33 donne donc les fichiers au bon propriétaire, vu du conteneur WordPress. Même geste qu'en VM, écrit en chiffres.
Pourquoi sed et pas nano. Pas d'éditeur convivial dans le noeud. sed -i remplace, dans le fichier même, la seule occurrence de 'localhost' du wp-config.php, à la ligne DB_HOST. Le grep qui suit vérifie le résultat. Si un jour il faut vraiment éditer dans un noeud, vi y est.
Pourquoi DB_HOST change. La sauvegarde vient du serveur en ligne, où la base de données vivait sur localhost, à côté du site. Ici, la base est un service de la pile nommé db, qui tourne sur un autre noeud que certaines répliques WordPress. C'est le DNS interne de l'essaim qui traduit ce nom, même d'un noeud à l'autre, grâce au réseau overlay net créé à l'étape 03. Aucun numéro IP dans la configuration.

Démarche - le repointage de l'adresse

La sauvegarde croit que le site vit à https://cornucopia.projet.autos. On ajoute à la fin de l'export les trois requêtes de repointage vues au laboratoire Docker : elles s'exécuteront toutes seules lors de l'import initial de la base, au premier démarrage du service db.

swarm-node04 seulement - le repointage à la fin de l'export, et le répertoire de la base
$ docker exec -it swarm-node04 sh
# cd /home/docker/swarm
# tee -a sauvegarde/base-de-donnees.sql <<'FIN'
UPDATE wp_options SET option_value='http://192.168.56.10'
    WHERE option_name IN ('siteurl','home');
UPDATE wp_posts SET post_content = REPLACE(post_content,
    'https://cornucopia.projet.autos', 'http://192.168.56.10');
UPDATE wp_posts SET guid = REPLACE(guid,
    'https://cornucopia.projet.autos', 'http://192.168.56.10');
FIN
# tail -n 6 sauvegarde/base-de-donnees.sql
# mkdir -p /home/docker/swarm/database
# le répertoire des données de MySQL : vide, mais il doit exister avant la pile
# ls -1 /home/docker/swarm
database
sauvegarde
sauvegarde-cornucopia-formation.zip
# exit
Pourquoi swarm-node04 seulement. La base y sera ancrée par la contrainte node.hostname == swarm-node04 de la pile, et c'est l'export de ce noeud qui sera monté dans /docker-entrypoint-initdb.d/. Le zip est aussi déballé sur swarm-node05, mais son export ne servira jamais : seul celui de swarm-node04 doit porter le repointage.
Pourquoi créer database à l'avance. Au laboratoire Docker, docker run -v créait tout seul un répertoire hôte manquant. Un service de l'essaim, lui, ne crée jamais la source d'un répertoire partagé : si /home/docker/swarm/database n'existe pas sur swarm-node04 au moment du déploiement, la tâche de la base est rejetée en boucle avec l'erreur invalid mount config for type "bind": bind source path does not exist, visible au service ps. Le répertoire des fichiers WordPress, lui, existe déjà : c'est le zip qui l'a créé. Un mkdir maintenant vous épargne une demi-heure de perplexité plus tard.
Pourquoi 192.168.56.10. Par le maillage de routage, n'importe quel noeud de l'essaim répond sur le port 80, mais WordPress n'a qu'une adresse dans sa base. On prend celle du chef, qui est aussi celle du tableau de bord Traefik et du visualiseur. Depuis votre Linux, cette adresse répond directement : le réseau reseau-swarm est branché sur votre machine. Avec un autre plan d'adressage, adaptez cette valeur : c'est la seule qui varie.
L'image mysql n'importe le fichier de /docker-entrypoint-initdb.d/ qu'au premier démarrage, quand /home/docker/swarm/database est vide sur swarm-node04. Si vous déployez la pile avant d'avoir ajouté le repointage, la base est créée avec l'ancienne adresse et le navigateur vous renvoie vers le vrai site, cornucopia.projet.autos. Corriger l'export après coup ne sert à rien : docker stack rm wordpress-sticky dans un gestionnaire, rm -rf /home/docker/swarm/database dans swarm-node04, corrigez l'export, puis redéployez. C'est le mécanisme de l'incendie volontaire du laboratoire Compose, vu de l'autre côté : là-bas on s'en sert pour renaître, ici il faut l'avoir compris pour ne pas se faire piéger. Question d'examen classique.
Avant de lancer quoi que ce soit : dans les deux travailleurs, ls /home/docker/swarm/sauvegarde montre les trois éléments et grep DB_HOST sauvegarde/fichiers-wordpress/wp-config.php répond db:3306; dans swarm-node04, tail -n 6 sauvegarde/base-de-donnees.sql montre les requêtes de repointage et ls /home/docker/swarm montre le répertoire database, vide. Rien n'est encore déployé, tout se corrige encore.
05

Répliquer Cornucopia : la pile, l'observation, la panne volontaire

Services

Déployer la pile wordpress-sticky : la base de données ancrée sur swarm-node04 avec ses données, WordPress en trois répliques derrière Traefik, puis la panne volontaire... qui ne perd rien.

Démarche - écrire la pile sur votre Linux

Votre Linux - le fichier de la pile Cornucopia
$ cd ~/swarm
$ nano wordpress-sticky.yml
# recopier le fichier complet ci-dessous, ou le télécharger :
$ wget https://evolutif.projet.autos/laboratoire/conteneurs/swarm/guide-dind/wordpress-sticky.yml
$ docker cp wordpress-sticky.yml swarm-node01:/home/docker/swarm/wordpress-sticky.yml
wordpress-sticky.yml - la pile complète
# Laboratoire Swarm (version Docker-in-Docker) - pile Cornucopia (etape 05 du guide)
# Preparation prealable (etape 04), dans les noeuds swarm-node04 ET swarm-node05 :
#   sauvegarde-cornucopia-formation.zip deballe dans /home/docker/swarm/sauvegarde/,
#   chown -R 33:33 sur fichiers-wordpress, wp-config.php ajuste (DB_HOST db:3306);
#   swarm-node04 seulement : les trois requetes de repointage a la fin de base-de-donnees.sql
# S'ecrit sur votre Linux dans ~/swarm, voyage vers le noeud, se deploie depuis swarm-node01 :
#   docker cp wordpress-sticky.yml swarm-node01:/home/docker/swarm/wordpress-sticky.yml
#   docker exec -it swarm-node01 sh
#   docker stack deploy --compose-file=/home/docker/swarm/wordpress-sticky.yml wordpress-sticky
version: "3.9"

services:
  db:
    image: mysql:8.0
    deploy:
      replicas: 1
      restart_policy:
        condition: on-failure
        max_attempts: 100
        delay: 3s
      placement:
        constraints: [node.hostname == swarm-node04]
    volumes:
      - /home/docker/swarm/database:/var/lib/mysql
      - /home/docker/swarm/sauvegarde/base-de-donnees.sql:/docker-entrypoint-initdb.d/base-de-donnees.sql
    networks:
      - net
    environment:
      MYSQL_ROOT_PASSWORD: racine-potager-2026
      MYSQL_DATABASE: cornucopia
      MYSQL_USER: flora
      MYSQL_PASSWORD: potager-2026

  wordpress:
    depends_on:
      - db
    image: wordpress:7.1
    deploy:
      mode: replicated
      replicas: 3
      restart_policy:
        condition: on-failure
        max_attempts: 10
        delay: 15s
      placement:
        constraints: [node.role == worker]
      update_config:
        delay: 2s
      labels:
        - "traefik.docker.network=net"
        - "traefik.port=80"
        - "traefik.frontend.rule=PathPrefix:/"
        - "traefik.backend.loadbalancer.sticky=true"
    # Pas de variables WORDPRESS_* : le wp-config.php de la sauvegarde est
    # monté avec les fichiers du site, l'image ne le remplace jamais.
    volumes:
      - /home/docker/swarm/sauvegarde/fichiers-wordpress:/var/www/html
    networks:
      - net
    ports:
      - "80"

networks:
  net:
    external: true

Ce que dit le fichier wordpress-sticky.yml

  • Le service db : une seule réplique, relancée sur échec (100 essais, 3 s), et placement: constraints: [node.hostname == swarm-node04] : la base est ancrée sur ce noeud. Ses données vivent dans le répertoire partagé /home/docker/swarm/database de swarm-node04; l'export déposé dans /docker-entrypoint-initdb.d/ est importé automatiquement au premier démarrage, quand ce répertoire est encore vide. Les variables d'environnement donnent exactement la base, le compte et les mots de passe que le wp-config.php de la sauvegarde attend (le README.md les récapitule).
  • Le service wordpress : l'image figée à wordpress:7.1 (le site de la sauvegarde est calibré sur elle), mode répliqué en 3 répliques, relancé sur échec (10 essais, 15 s), et placement: constraints: [node.role == worker] : uniquement sur swarm-node04 et 05, les noeuds qui possèdent les fichiers.
  • Les étiquettes traefik : le réseau à emprunter (net), le port du service (80), la règle de routage PathPrefix:/ (tout le trafic), et sticky=true : les sessions persistantes, un visiteur reste sur la même réplique.
  • Les répertoires partagés : /home/docker/swarm/sauvegarde/fichiers-wordpress monté dans /var/www/html, sur chaque travailleur. Le chemin est celui du noeud, pas celui de votre Linux : c'est le Docker du noeud qui monte. Pas de variables WORDPRESS_* : le wp-config.php de la sauvegarde est monté avec les fichiers du site, l'image ne le remplace jamais, et c'est lui qui raconte la connexion à la base.
  • ports: - "80" sans port hôte : l'essaim publie un port du maillage de routage (30000) sur tous les noeuds. Traefik, lui, parle à WordPress directement par le réseau net.
  • networks: net: external: true : la même règle que pour Traefik, la pile rejoint le réseau overlay existant.

Démarche - déployer et observer

swarm-node01 - déployer la pile
$ docker exec -it swarm-node01 sh
# docker stack deploy --compose-file=/home/docker/swarm/wordpress-sticky.yml wordpress-sticky
Since --detach=false was not specified, tasks will be created in the background.
In a future release, --detach=false will become the default.
Creating service wordpress-sticky_db
Creating service wordpress-sticky_wordpress
# docker service logs wordpress-sticky_db
# le premier démarrage importe base-de-donnees.sql : comptez quelques secondes
# docker service ps wordpress-sticky_wordpress
# docker service ps wordpress-sticky_db
ID             NAME                          IMAGE           NODE           DESIRED STATE   CURRENT STATE
qh6feyvj2s3z   wordpress-sticky_wordpress.1  wordpress:7.1   swarm-node04   Running         Preparing 6 minutes ago
ayf5pmrl3gyv   wordpress-sticky_wordpress.2  wordpress:7.1   swarm-node05   Running         Preparing 6 minutes ago
3y5xqzpcxfj5   wordpress-sticky_wordpress.3  wordpress:7.1   swarm-node05   Running         Preparing 6 minutes ago
ID             NAME                          IMAGE           NODE           DESIRED STATE   CURRENT STATE
nq9fzavxy2aw   wordpress-sticky_db.1         mysql:8.0       swarm-node04   Running         Running 48 seconds ago
# en cas de besoin, la pile se retire d'une commande :
# docker stack rm wordpress-sticky

Quelques minutes plus tard, service ps montre aussi des tâches en Shutdown Failed avec une erreur task: non-zero exit : WordPress a démarré avant que la base soit prête et a échoué, puis la politique de redémarrage l'a relancé. Ces erreurs ne sont pas graves pour notre exercice. Le filtre -f "desired-state=Running" met en évidence l'état recherché; sans lui, on retrouve tous les états historiques du service.

swarm-node01 - l'état recherché seulement
# docker service ps wordpress-sticky_wordpress
ID             NAME                            NODE           DESIRED STATE   CURRENT STATE            ERROR
qh6feyvj2s3z   wordpress-sticky_wordpress.1    swarm-node04   Running         Running 22 minutes ago
zkwpxvo4o958   wordpress-sticky_wordpress.2    swarm-node05   Running         Running 19 minutes ago
l6bbzpsu0dkc    \_ wordpress-sticky_wordpress.2   swarm-node05   Shutdown        Failed 20 minutes ago    "task: non-zero exit (4)"
ayf5pmrl3gyv    \_ wordpress-sticky_wordpress.2   swarm-node05   Shutdown        Failed 20 minutes ago    "task: non-zero exit (2)"
# docker service ps wordpress-sticky_wordpress -f "desired-state=Running"
ID             NAME                          NODE           DESIRED STATE   CURRENT STATE
b1be2u8mfq9l   wordpress-sticky_wordpress.1  swarm-node04   Running         Running 3 hours ago
3biuo0wwkd9n   wordpress-sticky_wordpress.2  swarm-node05   Running         Running 3 hours ago
ncljsjb28msn   wordpress-sticky_wordpress.3  swarm-node05   Running         Running 3 hours ago
# docker service ls
ID             NAME                         MODE         REPLICAS   IMAGE           PORTS
ilf1r38kh2j8   traefik_loadbalancer         replicated   1/1        traefik:1.7     *:80->80/tcp, *:9090->8080/tcp
ylml81vo6mdu   wordpress-sticky_db          replicated   1/1        mysql:8.0
vjwbih1it3t1   wordpress-sticky_wordpress   replicated   3/3        wordpress:7.1   *:30000->80/tcp
Si service ps wordpress-sticky_db montre des tâches Rejected avec « bind source path does not exist », le répertoire /home/docker/swarm/database manque sur swarm-node04 : créez-le (étape 04), l'essaim réessaie tout seul dans les secondes qui suivent. Le premier déploiement est long : chaque noeud télécharge ses propres images (MySQL sur swarm-node04, WordPress sur les deux travailleurs) et les services démarrent, comptez plusieurs minutes, jusqu'à une demi-heure selon la connexion. Même après un docker start des noeuds, quelques minutes sont à prévoir avant que le site réponde. Ne concluez pas trop vite à une erreur : service ps avec le filtre, puis patience.

Ce qu'il faut aller voir, dans le navigateur de votre Linux

  • http://192.168.56.10 : la boutique de Cornucopia s'affiche, avec ses articles, ses images, son module /abonnement/. Pas d'assistant d'installation : le site est transplanté, pas réinstallé. Par le maillage de routage, l'adresse de n'importe quel noeud répond aussi, http://192.168.56.30 par exemple, un gestionnaire qui ne porte aucune réplique.
  • http://192.168.56.10/wp-admin/ : le tableau de bord, avec flora et cornucopia-2026. Publiez un article avec une image : c'est la preuve demandée à l'évaluation. Avec les sessions persistantes, vous restez sur la réplique qui a reçu l'image.
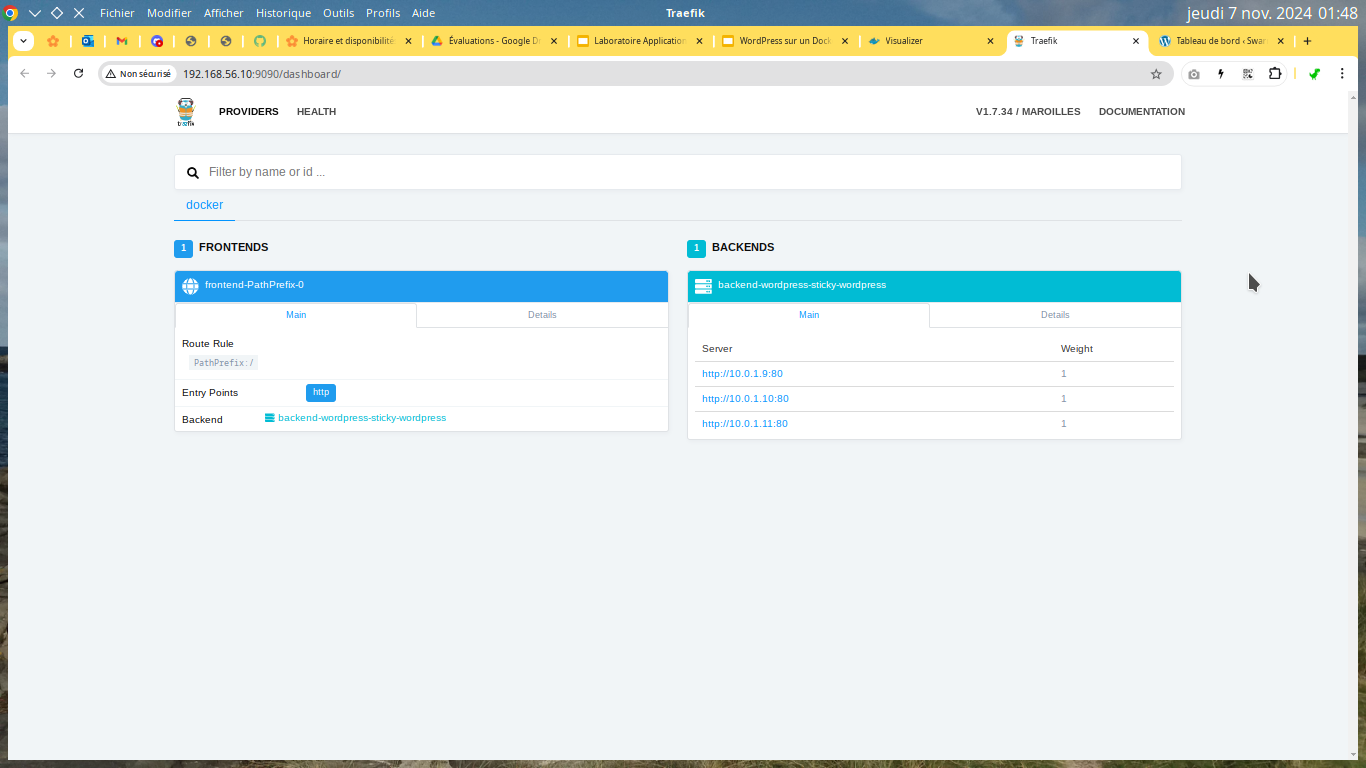
  • http://192.168.56.10:9090 : le tableau de bord Traefik montre maintenant le frontend PathPrefix:/ et un backend avec ses trois serveurs WordPress.
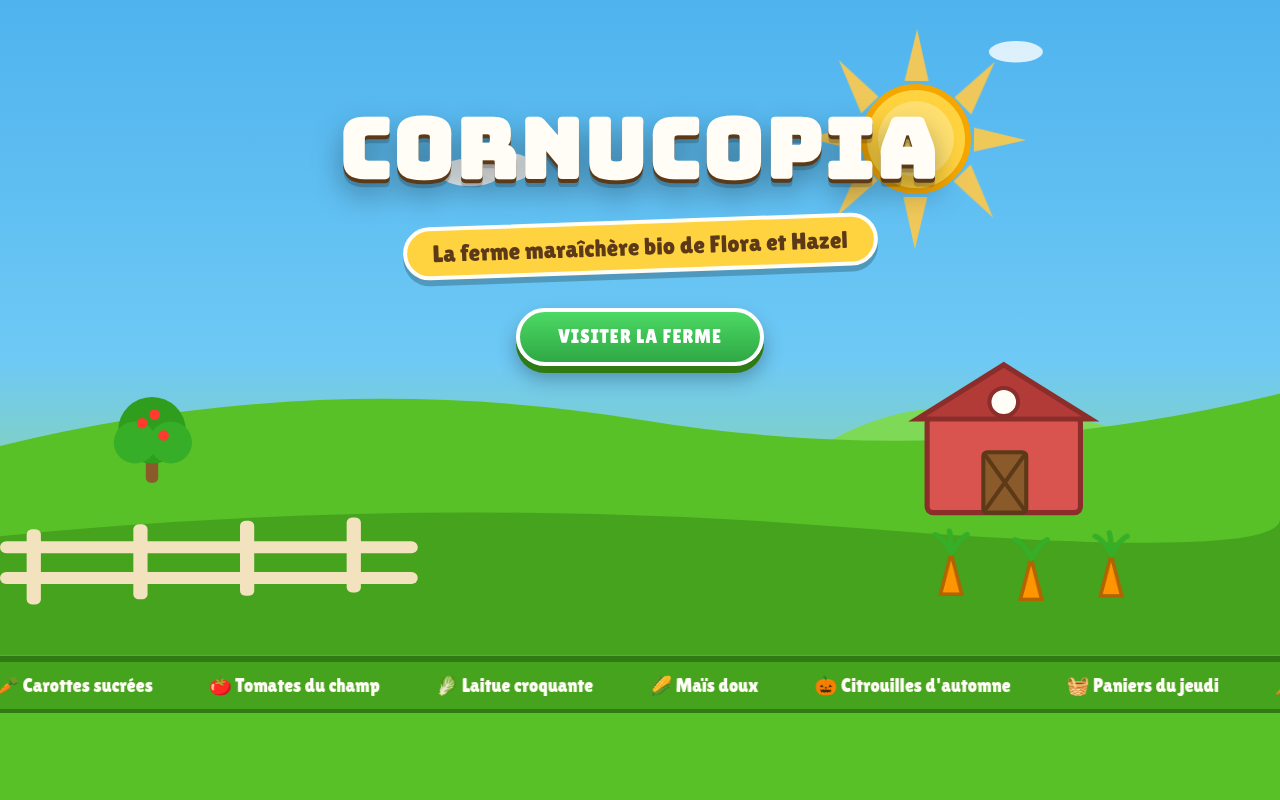
La boutique de Cornucopia servie par l'essaim, sur http://192.168.56.10 : le site existant de Flora, pas un WordPress vierge.
Le tableau de bord Traefik une fois la pile déployée : un frontend, un backend, trois serveurs WordPress répartis sur les travailleurs.

Ce qu'il faut observer

  • service ls : WordPress en 3/3, la base en 1/1.
  • service ps : les trois répliques WordPress réparties sur les deux travailleurs (l'un en porte deux); la base ancrée sur swarm-node04 (sa contrainte de placement), ses données dans le répertoire partagé /home/docker/swarm/database de ce noeud.
  • La boutique de Flora répond via Traefik sur le port 80 de n'importe quel noeud, avec ses articles et ses images : c'est le maillage de routage.
  • La base MySQL est en une seule réplique : l'état s'ancre, le sans-état se réplique.
  • Chaque travailleur sert SA copie des fichiers : un téléversement fait par une réplique n'apparaît pas sur l'autre. En production on cuirait les fichiers dans une image ou on partagerait un stockage : retenez cette limite.

Le grand final - la panne volontaire

  1. Notez sur quel noeud tourne une réplique WordPress (service ps).
  2. Éteignez ce noeud pour vrai, depuis votre Linux : docker stop swarm-node05. (L'autre façon, plus douce, depuis un gestionnaire : docker node update --availability drain swarm-node05.)
  3. Rejouez service ps : la tâche renaît sur un autre noeud, sans que personne ne clique... et la boutique répond toujours, avec toutes ses données. C'est la réconciliation. Une fois le visualiseur de l'étape 06 en place, rejouez la scène en le regardant.
  4. Rallumez le noeud : docker start swarm-node05. Il rejoint l'essaim tout seul, node ls le montre à nouveau Ready.
N'éteignez pas swarm-node04 : la base y est ancrée avec ses données, c'est le choix assumé du laboratoire (l'état s'ancre; la haute disponibilité des bases de données est l'affaire du module 2). Et si vous éteignez le gestionnaire chef (swarm-node01), vérifiez d'abord que les deux autres gestionnaires sont Reachable : ils éliront un nouveau chef. Avec un seul gestionnaire encore debout, plus de majorité : le cluster se fige.
Vous savez montrer : les cinq noeuds au node ls, le tableau de bord Traefik avec ses trois serveurs, la boutique Cornucopia répliquée qui répond avec ses articles et votre article illustré, et une tâche qui renaît ailleurs après la panne d'un noeud. C'est la démonstration attendue à l'évaluation.
06

Voir l'essaim : le visualiseur

Visualiseur

Déployer le visualiseur de Docker, un service de plus, ancré sur un gestionnaire, qui dessine les noeuds et leurs tâches en direct. C'est le conteneur Visualiseur du barème.

Pour mieux comprendre

Un service peut se créer sans pile, d'une seule commande docker service create : c'est exactement ce que stack deploy fait pour vous, service par service, en lisant le fichier YAML. Le visualiseur lit la socket Docker d'un gestionnaire, comme Traefik, et publie son port 8080 sur le port 5000 de l'essaim.

Démarche - dans swarm-node01

swarm-node01 - le service viz
# docker service create \
  --name=viz \
  --publish=5000:8080/tcp \
  --constraint=node.role==manager \
  --mount=type=bind,src=/var/run/docker.sock,dst=/var/run/docker.sock \
  dockersamples/visualizer
# docker service ps viz -f "desired-state=Running"
ID             NAME     IMAGE                           NODE           DESIRED STATE   CURRENT STATE
k2p7v1qz0m4n   viz.1    dockersamples/visualizer:latest swarm-node01   Running         Running 40 seconds ago

Ce que dit la commande

  • --name=viz : le nom du service, celui qu'on retrouve au service ls.
  • --publish=5000:8080/tcp : le port 8080 du visualiseur publié sur le port 5000 de tous les noeuds, par le maillage de routage.
  • --constraint=node.role==manager : la même contrainte de placement que Traefik, écrite en ligne de commande au lieu du YAML.
  • --mount=type=bind,src=/var/run/docker.sock,... : la socket Docker, la fenêtre sur l'essaim.
  • dockersamples/visualizer : l'image officielle de démonstration de Docker.
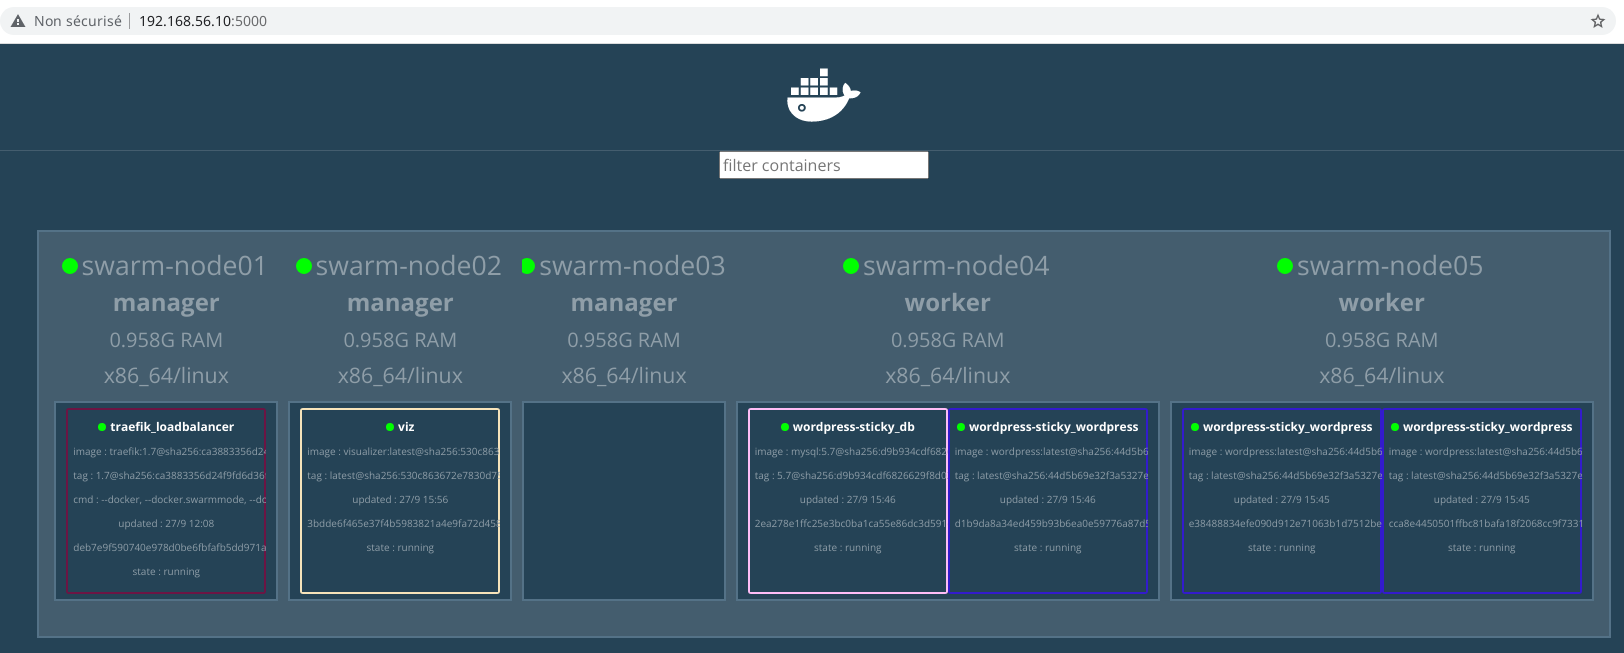
Le visualiseur sur http://192.168.56.10:5000 : les cinq noeuds et leurs tâches, Traefik et le visualiseur sur des gestionnaires, la base sur swarm-node04, les trois WordPress sur les travailleurs.

Rejouez maintenant la panne volontaire de l'étape 05 en gardant le visualiseur sous les yeux : docker stop swarm-node05 sur votre Linux, la tâche disparaît d'un noeud et renaît sur l'autre, en direct.

http://192.168.56.10:5000 montre les cinq noeuds : traefik_loadbalancer et viz sur des gestionnaires, wordpress-sticky_db sur swarm-node04, les trois wordpress-sticky_wordpress sur swarm-node04 et 05. Avec Traefik, les trois WordPress, MySQL et le visualiseur, les cinq conteneurs du barème sont en place.

Défis facultatifs

Défi A - Passer à l'échelle

Montez le service WordPress à 4 répliques avec docker service scale, observez leur placement dans le visualiseur, puis redescendez à 2. L'essaim fait tout le travail.

Défi B - Sans le proxy

service ls montre WordPress publié sur le port 30000 du maillage de routage. Visitez http://192.168.56.40:30000 puis http://192.168.56.20:30000 : un noeud sans réplique répond quand même. Rechargez plusieurs fois et comparez avec le passage par Traefik : où sont passées les sessions persistantes ?

Défi C - L'essaim minimal

L'énoncé permet un essaim de trois noeuds : refaites le montage en 1 gestionnaire + 2 travailleurs sur l'infrastructure de votre choix (DinD, VirtualBox ou VPS) et notez ce qui change... et ce qui ne change pas.

Défi D - L'école d'horticulture

La sauvegarde contient formation/, une application Node.js autonome (node serveur.js, port 3081, aucune dépendance). Elle mérite son propre service : ajoutez-le à la pile (image node, montage du répertoire, contrainte de placement) et faites-le répondre sur son port publié. Sa route /sante vous dira si tout va bien.

Défi E - L'essaim en un script

Les étapes 01 et 02 sont cinq fois la même commande et quatre fois le même join : écrivez monter-essaim.sh, un script bash qui crée le réseau, lance les cinq noeuds dans une boucle, initialise l'essaim et fait joindre les quatre autres avec docker exec et les jetons lus par docker swarm join-token -q. Un essaim neuf en une commande : c'est l'esprit de l'infrastructure programmable, et un bel ajout à votre remise.

Les fichiers complets

Pour vérifier votre travail ou repartir d'un bon pied : traefik.yml (étape 03) et wordpress-sticky.yml (étape 05), les deux piles telles que reproduites dans ce guide. La préparation des noeuds et de la sauvegarde (étapes 01, 02 et 04) reste à faire par vous. Le même laboratoire sur des machines virtuelles VirtualBox : la version machines virtuelles de ce guide.