SW Guide pas-à-pas - Laboratoire Swarm

L'essaim : WordPress répliqué
sur un cluster

Cinq machines qui agissent comme une seule, un proxy inverse qui route le trafic, et le site de Cornucopia qui se réplique. Six étapes guidées : MACHINES, ESSAIM, PROXY, SAUVEGARDE, SERVICES, VISUALISEUR.

Ce qu'on vous fournit

La sauvegarde complète du site en ligne cornucopia.projet.autos, la ferme de Flora et Hazel, en un seul fichier : sauvegarde-cornucopia-formation.zip (39 Mo). Il contient :

Comptes du tableau de bord pour ce laboratoire : agence, flora et hazel, tous avec le mot de passe cornucopia-2026. Base de données cornucopia, compte flora, mot de passe potager-2026, mot de passe root racine-potager-2026 : ce sont les valeurs que le wp-config.php de la sauvegarde attend. Les mots de passe ont été réinitialisés pour le laboratoire : ce ne sont pas ceux du site en production.

Les deux piles complètes, reproduites dans ce guide et téléchargeables : traefik.yml (étape 03) et wordpress-sticky.yml (étape 05). Quatre images de Docker Hub : traefik:1.7, wordpress (figée en version 7.1), mysql:8.0 et dockersamples/visualizer. Rien à construire cette semaine.

Le plan d'adressage des cinq noeuds : swarm-node01 192.168.56.10 (gestionnaire et chef), swarm-node02 .20 et swarm-node03 .30 (gestionnaires), swarm-node04 .40 (travailleur, porte la base de données) et swarm-node05 .50 (travailleur).

Vous produirez : vos cinq noeuds configurés, les deux piles déployées, le site existant qui revit sur l'essaim, le visualiseur, et votre README.md avec le journal des commandes. Dans votre dépôt Git, le dossier swarm/ contient traefik.yml, wordpress-sticky.yml et README.md.

Avant de commencer

Pré-requis

Vue d'ensemble

Le parcours en six étapes

La grande idée : déclarer un état désiré et laisser l'essaim le maintenir. Trois gestionnaires qui peuvent tous devenir chef, deux travailleurs qui portent WordPress, un proxy inverse Traefik qui route le trafic, et le site de Cornucopia, avec ses données, qui renaît répliqué : votre première architecture distribuée.

Étape 01 · Machines

Préparer les cinq noeuds

Étape 02 · Essaim

init, join et les jetons

Étape 03 · Proxy

Le réseau overlay et Traefik

Étape 04 · Sauvegarde

Le site existant sur les travailleurs

Étape 05 · Services

Répliquer le site Cornucopia

Étape 06 · Visualiseur

Voir l'essaim en direct

01

Préparer les machines : cinq noeuds qui se connaissent

Machines

Cloner cinq machines virtuelles avec Docker installé, nommées swarm-node01 à swarm-node05, aux adresses 192.168.56.10 à .50, qui se joignent par leur nom.

Démarche - la machine de base

Clonez UbuntuServerAlpha en DockerAlpha, installez-y Docker et le plugin Compose (sudo docker compose version répond), puis clonez DockerAlpha cinq fois. Les instructions qui suivent se répètent, à la lettre, sur chacun des cinq clones.

Démarche - sur chacune des cinq machines

  • Le nom : sudo nano /etc/hostname avec la valeur du noeud (swarm-node01, 02...).
  • Le carnet d'adresses : sudo nano /etc/hosts avec les cinq noeuds (et sans ligne 127.0.0.1 swarm-node0X) :
/etc/hosts - identique sur les cinq noeuds
192.168.56.10 swarm-node01
192.168.56.20 swarm-node02
192.168.56.30 swarm-node03
192.168.56.40 swarm-node04
192.168.56.50 swarm-node05
  • L'adresse : mettre à jour netplan avec la valeur du noeud (.10, .20, .30, .40, .50), désactiver la configuration cloud-init, puis appliquer :
Terminal - le réseau de chaque noeud
$ sudo mv /etc/netplan/50-cloud-init.yaml /etc/netplan/00-installer-config.yaml
$ sudo nano /etc/netplan/00-installer-config.yaml
$ sudo nano /etc/cloud/cloud.cfg.d/99-disable-network-config.cfg
# contenu : network: {config: disabled}
$ sudo netplan apply
$ sudo reboot now
Exemple de 00-installer-config.yaml pour VirtualBox (une carte NAT pour sortir, une carte réseau privé hôte pour l'essaim), ici pour swarm-node01. Les deux cartes, leurs adresses et le réseau qu'elles forment sont expliqués dans le diaporama Laboratoire de virtualisation de serveurs avec VirtualBox, et la machine se crée pas à pas avec le diaporama Créer une machine virtuelle. Le nom des interfaces se lit avec ip a et l'adresse change d'un noeud à l'autre :
00-installer-config.yaml - exemple pour swarm-node01, à adapter
network:
  version: 2
  ethernets:
    enp0s3:
      dhcp4: true
    enp0s8:
      addresses: [192.168.56.10/24]
Respectez les instructions à la lettre : un noeud dont le nom dans /etc/hostname ne correspond pas au carnet /etc/hosts sèmera la confusion dans tout le cluster. Et pas de tabulation dans le fichier netplan : c'est du YAML, deux espaces par niveau.
Depuis swarm-node01, ping swarm-node05 répond : les noeuds se trouvent par leur nom. Sur chaque noeud, sudo docker compose version répond aussi.
02

Monter l'essaim : init, les jetons, join

Essaim

Initialiser le cluster sur le premier noeud, puis y joindre deux autres gestionnaires (haute disponibilité du cerveau) et deux travailleurs (les bras qui porteront WordPress).

Pour mieux comprendre

docker swarm init génère deux jetons : un jeton de travailleur et un jeton de gestionnaire. Le jeton utilisé au join décide du rôle du noeud. Trois gestionnaires : le cluster survit à la perte de l'un d'eux, chacun pouvant devenir chef. Le premier noeud devient gestionnaire et chef (Leader); les deux autres gestionnaires sont Reachable, prêts à prendre le relais. Swarm gère ensuite le cluster comme une seule et unique machine Docker.

Démarche - initialiser

swarm-node01 - initialiser l'essaim
$ sudo docker swarm init --advertise-addr 192.168.56.10
Swarm initialized: current node (r7148q9ah4fd7791d7l5we4ux) is now a manager.

To add a worker to this swarm, run the following command:

    docker swarm join --token SWMTKN-1-2r65sjv0i9bcoj7k1ha4677icdqc6ugmh64v4ikme745x06f08-0lzb6ibtbptq9xo1wylep5fab 192.168.56.10:2377

To add a manager to this swarm, run 'docker swarm join-token manager' and follow the instructions.
# le jeton affiché ici est celui des TRAVAILLEURS : gardez-le pour swarm-node04 et 05
$ sudo docker swarm join-token manager
To add a manager to this swarm, run the following command:

    docker swarm join --token SWMTKN-1-2r65sjv0i9bcoj7k1ha4677icdqc6ugmh64v4ikme745x06f08-3gy8clp83dyueds2zjgsk0jaf 192.168.56.10:2377
# celui-ci est le jeton des GESTIONNAIRES : pour swarm-node02 et 03

Les jetons ci-dessus sont ceux d'un exemple : les vôtres seront différents, recopiez-les depuis votre propre sortie. sudo docker swarm join-token worker réaffiche celui des travailleurs en cas de besoin.

Démarche - rejoindre

Les quatre autres noeuds - rejoindre l'essaim
# swarm-node02 et 03 : avec le jeton de GESTIONNAIRE
$ sudo docker swarm join --token JETON-MANAGER 192.168.56.10:2377
This node joined a swarm as a manager.

# swarm-node04 et 05 : avec le jeton de TRAVAILLEUR (celui du init)
$ sudo docker swarm join --token JETON-WORKER 192.168.56.10:2377
This node joined a swarm as a worker.
swarm-node01 - les cinq noeuds
$ sudo docker node ls
ID                            HOSTNAME       STATUS    AVAILABILITY   MANAGER STATUS
r7148q9ah4fd7791d7l5we4ux *   swarm-node01   Ready     Active         Leader
c61vudkv1cwqycob0nhxwtm8y     swarm-node02   Ready     Active         Reachable
yjhc5irll92tyrideogxs75zg     swarm-node03   Ready     Active         Reachable
xji0f3arb97n3d5oqqsa1fwoz     swarm-node04   Ready     Active
9s8c9yqq2g4dsrosfwr356ssu     swarm-node05   Ready     Active
Deux jetons différents pour deux rôles différents : joindre un noeud avec le mauvais jeton lui donne le mauvais rôle. --advertise-addr est indispensable dès qu'une machine a plusieurs adresses IP, ce qui est le cas ici (NAT et réseau privé hôte). Les commandes de gestion (node ls, stack deploy, service ls) ne fonctionnent que sur un gestionnaire.
Sur un gestionnaire, sudo docker node ls montre les cinq noeuds : trois avec un statut de gestionnaire (Leader ou Reachable), deux travailleurs, tous Ready. Vous avez désormais un cluster Swarm opérationnel et prêt à recevoir vos conteneurs.
03

Le réseau et le proxy : overlay et Traefik

Proxy

Créer le réseau overlay qui relie les services d'un noeud à l'autre, puis déployer la première pile : Traefik, le proxy inverse qui routera le trafic vers WordPress et gardera les sessions persistantes.

Pour mieux comprendre

Une pile (stack) est une partition Compose que l'essaim déploie : mêmes services, mêmes réseaux, plus une section deploy qui dit combien de répliques et sur quels noeuds. Le réseau overlay est le réseau multi-hôtes de l'essaim : deux services placés sur deux machines différentes s'y parlent comme s'ils étaient voisins, et se trouvent par leur nom.

Démarche - depuis swarm-node01

swarm-node01 - le réseau et le fichier de la pile
$ sudo docker network create -d overlay net
$ sudo mkdir -p /home/docker/swarm/
$ sudo nano /home/docker/swarm/traefik.yml

La pile à écrire, telle quelle : rien à compléter, ce sont les valeurs du diaporama. Le service s'appelle loadbalancer; la pile, elle, s'appellera traefik au déploiement.

traefik.yml - la pile
version: '3.2'

services:
  loadbalancer:
    image: traefik:1.7
    command: --docker \
      --docker.swarmmode \
      --docker.watch \
      --web \
      --loglevel=DEBUG
    ports:
      - 80:80
      - 9090:8080
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    deploy:
      restart_policy:
        condition: any
      mode: replicated
      replicas: 1
      update_config:
        delay: 2s
      placement:
        constraints: [node.role == manager]
    networks:
      - net

networks:
  net:
    external: true

Ce que dit le fichier traefik.yml

  • command: : --docker --docker.swarmmode : Traefik découvre tout seul les services de l'essaim; --docker.watch : il suit leurs changements en direct; --web : son tableau de bord, sur son port 8080; --loglevel=DEBUG : bavard, pour apprendre.
  • ports: : 80 (le trafic des visiteurs) et 9090 (le tableau de bord, relié au 8080 interne).
  • volumes: /var/run/docker.sock : la fenêtre de Traefik sur l'essaim. C'est par cette socket qu'il lit l'état des services, et c'est pourquoi il doit tourner sur un gestionnaire.
  • deploy: : la section qui n'existait pas en Compose : politique de redémarrage (any), mode répliqué, une réplique, mise à jour avec 2 s de délai.
  • placement: constraints: [node.role == manager] : Traefik est ancré sur un gestionnaire : votre première contrainte de placement.
  • networks: net: external: true : la pile rejoint le réseau overlay créé à la main, elle ne le crée pas.
swarm-node01 - déployer la pile
$ sudo docker stack deploy --compose-file=/home/docker/swarm/traefik.yml traefik
Creating service traefik_loadbalancer
$ sudo docker service ls
ID             NAME                   MODE         REPLICAS   IMAGE         PORTS
u4owhzune8fw   traefik_loadbalancer   replicated   1/1        traefik:1.7   *:80->80/tcp, *:9090->8080/tcp
# en cas de besoin, la pile se retire d'une commande :
$ sudo docker stack rm traefik
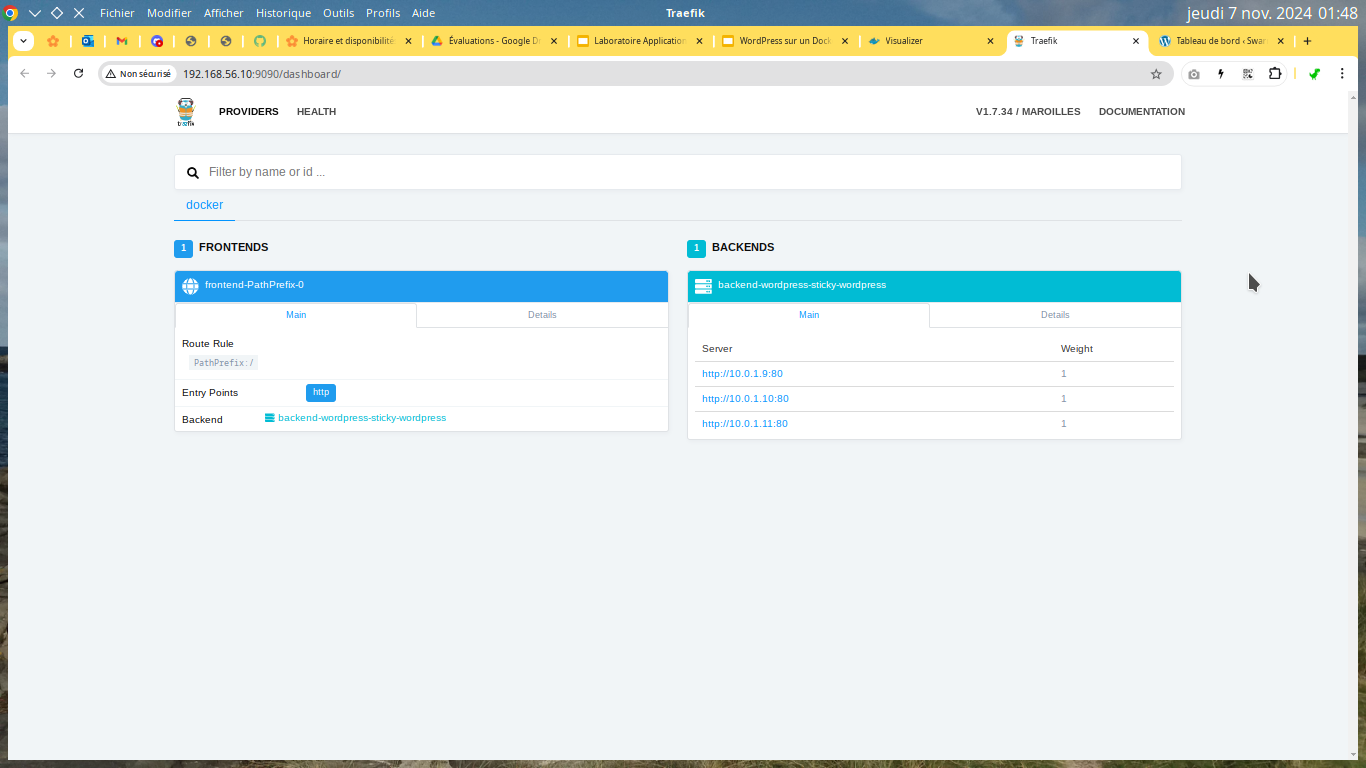
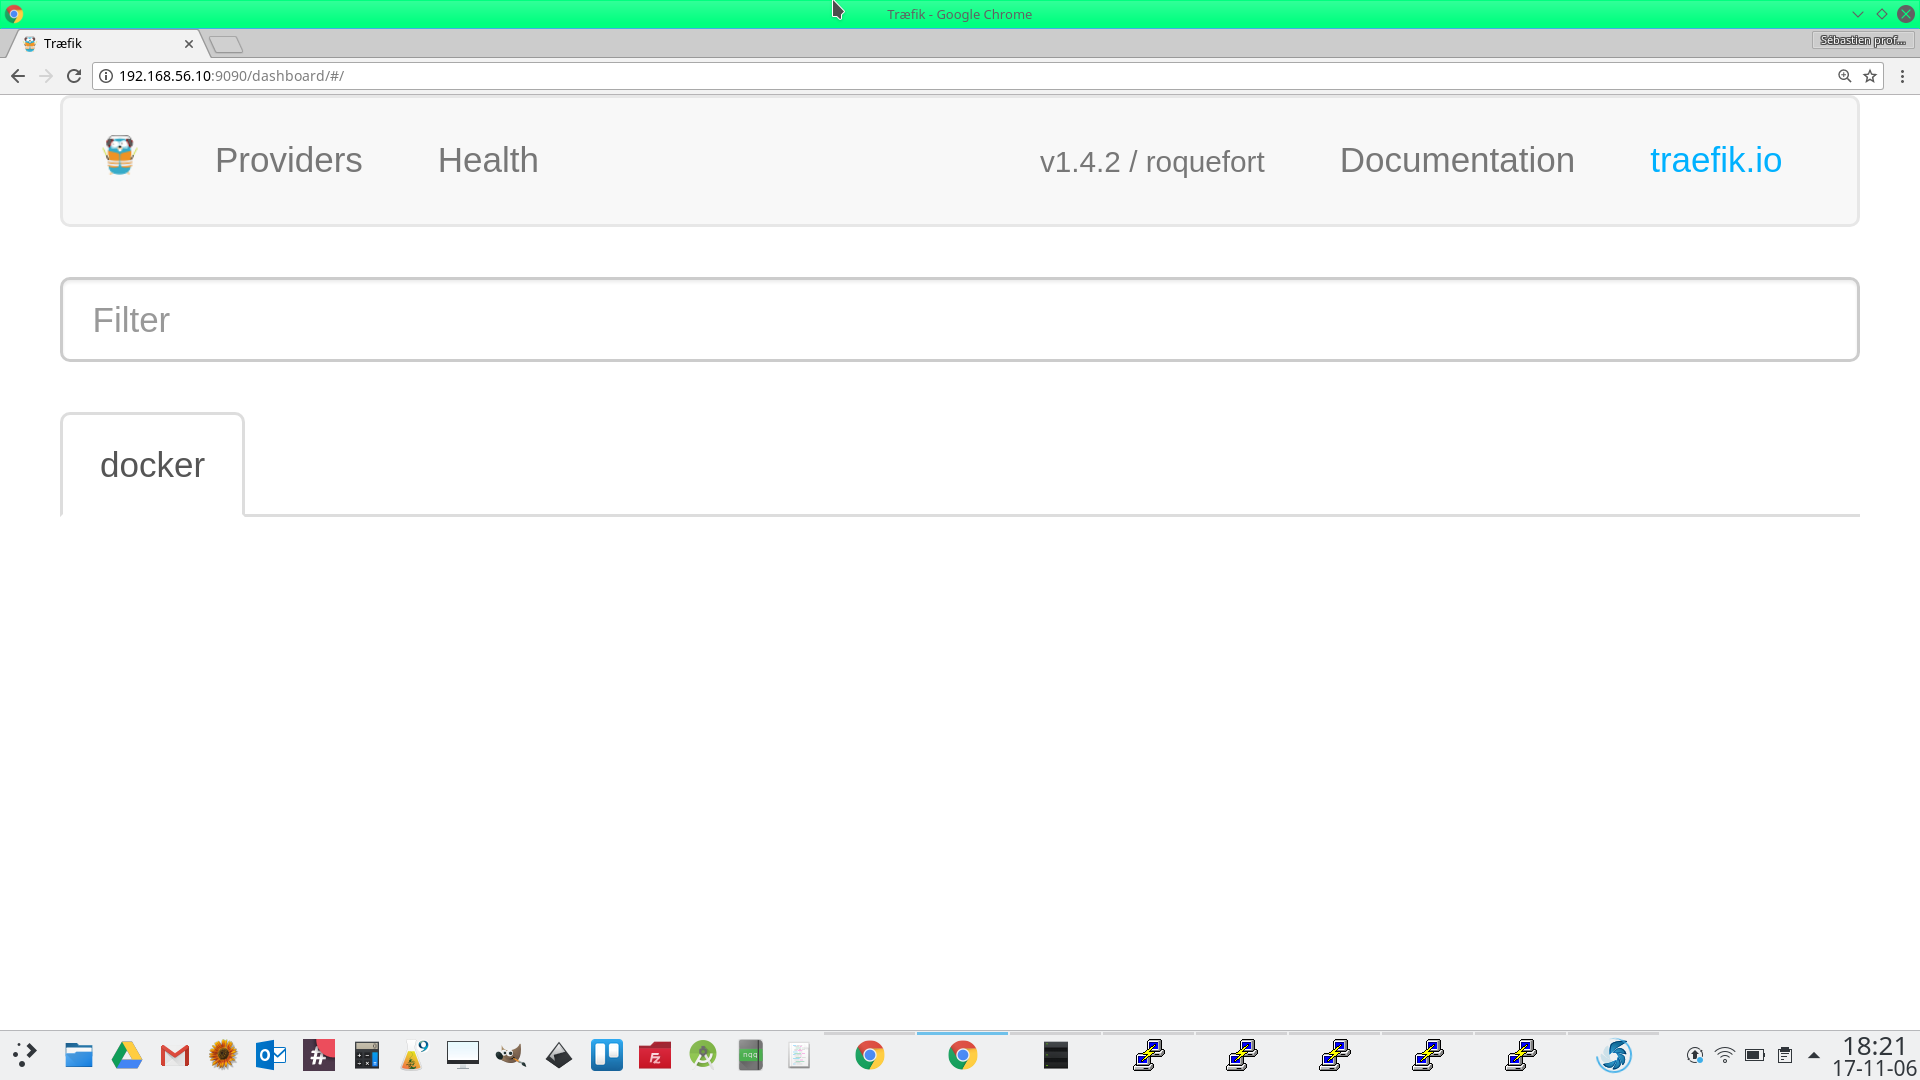
Le tableau de bord Traefik sur http://192.168.56.10:9090 : en fonction, mais encore vide, aucun service WordPress ne lui est présenté.
Après 2 ou 3 minutes, le tableau de bord Traefik répond sur http://192.168.56.10:9090 et service ls montre traefik_loadbalancer en 1/1.
04

Récupérer le site existant : la sauvegarde sur les travailleurs

Sauvegarde

Déposer la sauvegarde de Cornucopia sur les deux travailleurs, au même chemin, puis faire les deux ajustements déjà vus au laboratoire Compose : la base de données vers le service db, et le repointage de l'adresse dans l'export.

Pour mieux comprendre

On ne repart pas d'un site vide : la sauvegarde complète de la ferme (fichiers et base de données) reprend vie sur le cluster, comme aux laboratoires Docker et Compose. L'image wordpress:7.1 repart à neuf, mais le site et sa base de données sont ceux de Flora : rien ne disparaît.

Le problème que cette étape résout. Au laboratoire Compose, tout se passait sur une seule machine : le zip déballé à côté de la partition, et les répertoires partagés qui pointent dessus. Dans l'essaim, la pile est déployée depuis swarm-node01, mais les conteneurs WordPress tourneront sur swarm-node04 et 05, et la base sur swarm-node04. Or l'essaim ne copie jamais un fichier d'un noeud à l'autre. Un répertoire partagé dans une pile veut dire « ce chemin, sur le noeud où la tâche atterrit ». Si les fichiers n'y sont pas, WordPress démarre sur un répertoire vide et l'image installe un site vierge. D'où cette étape à part, avant la pile : on prépare le terrain sur les travailleurs, puis on décrit et on déploie depuis le gestionnaire.

Les trois gestes, et sur quels noeuds

  • Déballer le zip sur les deux travailleurs, swarm-node04 et swarm-node05, au même chemin /home/docker/swarm/sauvegarde.
  • Changer une ligne de wp-config.php, sur les deux travailleurs aussi : DB_HOST devient db:3306.
  • Le repointage de l'adresse, à la fin de l'export, sur swarm-node04 seulement.

Démarche - la sauvegarde sur chaque travailleur

swarm-node04 ET swarm-node05 - déballer la sauvegarde
$ sudo mkdir -p /home/docker/swarm
$ cd /home/docker/swarm
$ sudo wget https://evolutif.projet.autos/laboratoire/conteneurs/swarm/guide/sauvegarde-cornucopia-formation.zip
$ sudo unzip sauvegarde-cornucopia-formation.zip -d sauvegarde
$ ls sauvegarde
base-de-donnees.sql  fichiers-wordpress  README.md
$ sudo chown -R www-data:www-data sauvegarde/fichiers-wordpress
# Apache, dans les conteneurs WordPress, doit pouvoir écrire (téléversements, mises à jour)
$ sudo nano sauvegarde/fichiers-wordpress/wp-config.php
# la base ne vit plus sur localhost mais dans le service db, une seule ligne change :
#     define( 'DB_HOST', 'db:3306' );

Les deux travailleurs, parce que la contrainte de placement de la pile dira « n'importe quel travailleur » : une réplique WordPress peut atterrir sur l'un ou sur l'autre, et chacun doit trouver le site au même chemin. Le chown vers www-data permet à Apache, dans le conteneur, d'écrire ses téléversements et ses mises à jour.

Pourquoi DB_HOST change. La sauvegarde vient du serveur en ligne, où la base de données vivait sur localhost, à côté du site. Ici, la base est un service de la pile nommé db, qui tourne sur un autre noeud que certaines répliques WordPress. C'est le DNS interne de l'essaim qui traduit ce nom, même d'un noeud à l'autre, grâce au réseau overlay net créé à l'étape 03. Aucun numéro IP dans la configuration.

Démarche - le repointage de l'adresse

La sauvegarde croit que le site vit à https://cornucopia.projet.autos. On ajoute à la fin de l'export les trois requêtes de repointage vues au laboratoire Docker : elles s'exécuteront toutes seules lors de l'import initial de la base, au premier démarrage du service db.

swarm-node04 seulement - le repointage à la fin de l'export
$ sudo tee -a sauvegarde/base-de-donnees.sql <<'FIN'
UPDATE wp_options SET option_value='http://192.168.56.10'
    WHERE option_name IN ('siteurl','home');
UPDATE wp_posts SET post_content = REPLACE(post_content,
    'https://cornucopia.projet.autos', 'http://192.168.56.10');
UPDATE wp_posts SET guid = REPLACE(guid,
    'https://cornucopia.projet.autos', 'http://192.168.56.10');
FIN
Pourquoi swarm-node04 seulement. La base y sera ancrée par la contrainte node.hostname == swarm-node04 de la pile, et c'est l'export de ce noeud qui sera monté dans /docker-entrypoint-initdb.d/. Le zip est aussi déballé sur swarm-node05, mais son export ne servira jamais : seul celui de swarm-node04 doit porter le repointage.
Pourquoi 192.168.56.10. Par le maillage de routage, n'importe quel noeud de l'essaim répond sur le port 80, mais WordPress n'a qu'une adresse dans sa base. On prend celle du chef, qui est aussi celle du tableau de bord Traefik et du visualiseur. Avec un autre plan d'adressage, adaptez cette valeur : c'est la seule qui varie.
L'image mysql n'importe le fichier de /docker-entrypoint-initdb.d/ qu'au premier démarrage, quand /home/docker/swarm/database est vide sur swarm-node04. Si vous déployez la pile avant d'avoir ajouté le repointage, la base est créée avec l'ancienne adresse et le navigateur vous renvoie vers le vrai site, cornucopia.projet.autos. Corriger l'export après coup ne sert à rien : docker stack rm wordpress-sticky depuis un gestionnaire, sudo rm -rf /home/docker/swarm/database sur swarm-node04, corrigez l'export, puis redéployez. C'est le mécanisme de l'incendie volontaire du laboratoire Compose, vu de l'autre côté : là-bas on s'en sert pour renaître, ici il faut l'avoir compris pour ne pas se faire piéger. Question d'examen classique.
Avant de lancer quoi que ce soit : sur les deux travailleurs, ls /home/docker/swarm/sauvegarde montre les trois éléments et grep DB_HOST sauvegarde/fichiers-wordpress/wp-config.php répond db:3306; sur swarm-node04, tail -n 6 sauvegarde/base-de-donnees.sql montre les requêtes de repointage. Rien n'est encore déployé, tout se corrige encore d'un simple nano.
05

Répliquer Cornucopia : la pile, l'observation, la panne volontaire

Services

Déployer la pile wordpress-sticky : la base de données ancrée sur swarm-node04 avec ses données, WordPress en trois répliques derrière Traefik, puis la panne volontaire... qui ne perd rien.

Démarche - écrire la pile

swarm-node01 - le fichier de la pile Cornucopia
$ sudo nano /home/docker/swarm/wordpress-sticky.yml
# recopier le fichier complet ci-dessous, ou le télécharger :
$ sudo wget -O /home/docker/swarm/wordpress-sticky.yml https://evolutif.projet.autos/laboratoire/conteneurs/swarm/guide/wordpress-sticky.yml
wordpress-sticky.yml - la pile complète
# Laboratoire Swarm - pile Cornucopia, le site existant transplante (etape 05 du guide)
# Preparation prealable (etape 04) :
#   - swarm-node04 ET swarm-node05 : sauvegarde-cornucopia-formation.zip deballe
#     dans /home/docker/swarm/sauvegarde/, wp-config.php ajuste (DB_HOST db:3306)
#   - swarm-node04 seulement : les trois requetes de repointage ajoutees a la fin
#     de base-de-donnees.sql (executees lors de l'import initial)
# Se deploie depuis swarm-node01 :
#   sudo docker stack deploy --compose-file=/home/docker/swarm/wordpress-sticky.yml wordpress-sticky
version: "3.9"

services:
  db:
    image: mysql:8.0
    deploy:
      replicas: 1
      restart_policy:
        condition: on-failure
        max_attempts: 100
        delay: 3s
      placement:
        constraints: [node.hostname == swarm-node04]
    volumes:
      - /home/docker/swarm/database:/var/lib/mysql
      - /home/docker/swarm/sauvegarde/base-de-donnees.sql:/docker-entrypoint-initdb.d/base-de-donnees.sql
    networks:
      - net
    environment:
      MYSQL_ROOT_PASSWORD: racine-potager-2026
      MYSQL_DATABASE: cornucopia
      MYSQL_USER: flora
      MYSQL_PASSWORD: potager-2026

  wordpress:
    depends_on:
      - db
    image: wordpress:7.1
    deploy:
      mode: replicated
      replicas: 3
      restart_policy:
        condition: on-failure
        max_attempts: 10
        delay: 15s
      placement:
        constraints: [node.role == worker]
      update_config:
        delay: 2s
      labels:
        - "traefik.docker.network=net"
        - "traefik.port=80"
        - "traefik.frontend.rule=PathPrefix:/"
        - "traefik.backend.loadbalancer.sticky=true"
    # Pas de variables WORDPRESS_* : le wp-config.php de la sauvegarde est
    # monté avec les fichiers du site, l'image ne le remplace jamais.
    volumes:
      - /home/docker/swarm/sauvegarde/fichiers-wordpress:/var/www/html
    networks:
      - net
    ports:
      - "80"

networks:
  net:
    external: true

Ce que dit le fichier wordpress-sticky.yml

  • Le service db : une seule réplique, relancée sur échec (100 essais, 3 s), et placement: constraints: [node.hostname == swarm-node04] : la base est ancrée sur ce noeud. Ses données vivent dans le répertoire partagé /home/docker/swarm/database de swarm-node04; l'export déposé dans /docker-entrypoint-initdb.d/ est importé automatiquement au premier démarrage, quand ce répertoire est encore vide. Les variables d'environnement donnent exactement la base, le compte et les mots de passe que le wp-config.php de la sauvegarde attend (le README.md les récapitule).
  • Le service wordpress : l'image figée à wordpress:7.1 (le site de la sauvegarde est calibré sur elle), mode répliqué en 3 répliques, relancé sur échec (10 essais, 15 s), et placement: constraints: [node.role == worker] : uniquement sur swarm-node04 et 05, les noeuds qui possèdent les fichiers.
  • Les étiquettes traefik : le réseau à emprunter (net), le port du service (80), la règle de routage PathPrefix:/ (tout le trafic), et sticky=true : les sessions persistantes, un visiteur reste sur la même réplique.
  • Les répertoires partagés : /home/docker/swarm/sauvegarde/fichiers-wordpress monté dans /var/www/html, sur chaque travailleur. Pas de variables WORDPRESS_* : le wp-config.php de la sauvegarde est monté avec les fichiers du site, l'image ne le remplace jamais, et c'est lui qui raconte la connexion à la base.
  • ports: - "80" sans port hôte : l'essaim publie un port du maillage de routage (30000) sur tous les noeuds. Traefik, lui, parle à WordPress directement par le réseau net.
  • networks: net: external: true : la même règle que pour Traefik, la pile rejoint le réseau overlay existant.

Démarche - déployer et observer

swarm-node01 - déployer la pile
$ sudo docker stack deploy --compose-file=/home/docker/swarm/wordpress-sticky.yml wordpress-sticky
Creating service wordpress-sticky_db
Creating service wordpress-sticky_wordpress
$ sudo docker service logs wordpress-sticky_db
# le premier démarrage importe base-de-donnees.sql : comptez quelques secondes
$ sudo docker service ps wordpress-sticky_wordpress
$ sudo docker service ps wordpress-sticky_db
ID             NAME                          IMAGE           NODE           DESIRED STATE   CURRENT STATE
qh6feyvj2s3z   wordpress-sticky_wordpress.1  wordpress:7.1   swarm-node04   Running         Preparing 6 minutes ago
ayf5pmrl3gyv   wordpress-sticky_wordpress.2  wordpress:7.1   swarm-node05   Running         Preparing 6 minutes ago
3y5xqzpcxfj5   wordpress-sticky_wordpress.3  wordpress:7.1   swarm-node05   Running         Preparing 6 minutes ago
ID             NAME                          IMAGE           NODE           DESIRED STATE   CURRENT STATE
nq9fzavxy2aw   wordpress-sticky_db.1         mysql:8.0       swarm-node04   Running         Running 48 seconds ago
# en cas de besoin, la pile se retire d'une commande :
$ sudo docker stack rm wordpress-sticky

Quelques minutes plus tard, service ps montre aussi des tâches en Shutdown Failed avec une erreur task: non-zero exit : WordPress a démarré avant que la base soit prête et a échoué, puis la politique de redémarrage l'a relancé. Ces erreurs ne sont pas graves pour notre exercice. Le filtre -f "desired-state=Running" met en évidence l'état recherché; sans lui, on retrouve tous les états historiques du service.

swarm-node01 - l'état recherché seulement
$ sudo docker service ps wordpress-sticky_wordpress
ID             NAME                            NODE           DESIRED STATE   CURRENT STATE            ERROR
qh6feyvj2s3z   wordpress-sticky_wordpress.1    swarm-node04   Running         Running 22 minutes ago
zkwpxvo4o958   wordpress-sticky_wordpress.2    swarm-node05   Running         Running 19 minutes ago
l6bbzpsu0dkc    \_ wordpress-sticky_wordpress.2   swarm-node05   Shutdown        Failed 20 minutes ago    "task: non-zero exit (4)"
ayf5pmrl3gyv    \_ wordpress-sticky_wordpress.2   swarm-node05   Shutdown        Failed 20 minutes ago    "task: non-zero exit (2)"
$ sudo docker service ps wordpress-sticky_wordpress -f "desired-state=Running"
ID             NAME                          NODE           DESIRED STATE   CURRENT STATE
b1be2u8mfq9l   wordpress-sticky_wordpress.1  swarm-node04   Running         Running 3 hours ago
3biuo0wwkd9n   wordpress-sticky_wordpress.2  swarm-node05   Running         Running 3 hours ago
ncljsjb28msn   wordpress-sticky_wordpress.3  swarm-node05   Running         Running 3 hours ago
$ sudo docker service ls
ID             NAME                         MODE         REPLICAS   IMAGE           PORTS
u4owhzune8fw   traefik_loadbalancer         replicated   1/1        traefik:1.7     *:80->80/tcp, *:9090->8080/tcp
dcjiyrbrso5l   wordpress-sticky_db          replicated   1/1        mysql:8.0
9lsrr1xf36kr   wordpress-sticky_wordpress   replicated   3/3        wordpress:7.1   *:30000->80/tcp
Le premier déploiement est long : les images se téléchargent sur chaque noeud et les services démarrent, comptez jusqu'à une demi-heure. Même après un redémarrage des machines virtuelles, plusieurs minutes sont à prévoir avant que le site réponde. Ne concluez pas trop vite à une erreur : service ps avec le filtre, puis patience.

Ce qu'il faut aller voir

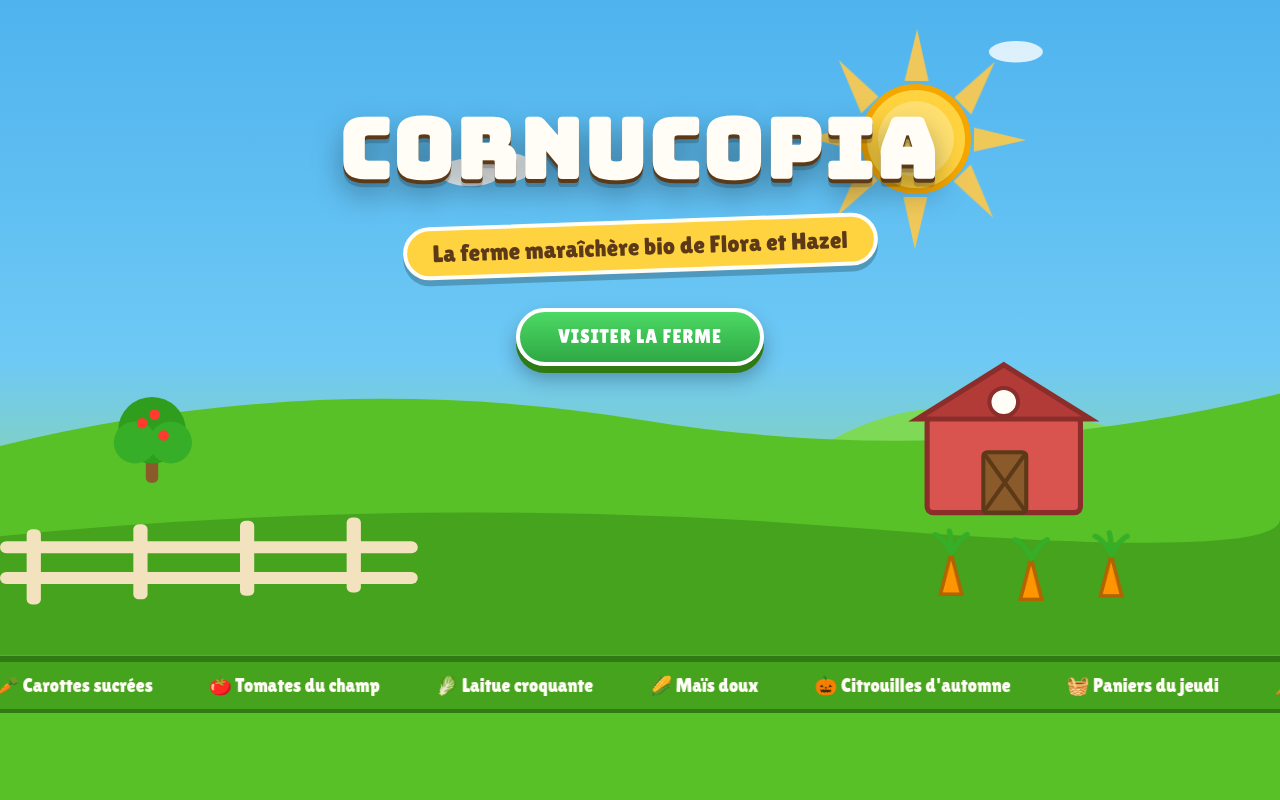
  • http://192.168.56.10 : la boutique de Cornucopia s'affiche, avec ses articles, ses images, son module /abonnement/. Pas d'assistant d'installation : le site est transplanté, pas réinstallé. Par le maillage de routage, l'adresse de n'importe quel noeud répond aussi.
  • http://192.168.56.10/wp-admin/ : le tableau de bord, avec flora et cornucopia-2026. Publiez un article avec une image : c'est la preuve demandée à l'évaluation. Avec les sessions persistantes, vous restez sur la réplique qui a reçu l'image.
  • http://192.168.56.10:9090 : le tableau de bord Traefik montre maintenant le frontend PathPrefix:/ et un backend avec ses trois serveurs WordPress.
La boutique de Cornucopia servie par l'essaim, sur http://192.168.56.10 : le site existant de Flora, pas un WordPress vierge.
Le tableau de bord Traefik une fois la pile déployée : un frontend, un backend, trois serveurs WordPress répartis sur les travailleurs.

Ce qu'il faut observer

  • service ls : WordPress en 3/3, la base en 1/1.
  • service ps : les trois répliques WordPress réparties sur les deux travailleurs (l'un en porte deux); la base ancrée sur swarm-node04 (sa contrainte de placement), ses données dans le répertoire partagé /home/docker/swarm/database.
  • La boutique de Flora répond via Traefik sur le port 80 de n'importe quel noeud, avec ses articles et ses images : c'est le maillage de routage.
  • La base MySQL est en une seule réplique : l'état s'ancre, le sans-état se réplique.
  • Chaque travailleur sert SA copie des fichiers : un téléversement fait par une réplique n'apparaît pas sur l'autre. En production on cuirait les fichiers dans une image ou on partagerait un stockage : retenez cette limite.

Le grand final - la panne volontaire

  1. Notez sur quel noeud tourne une réplique WordPress (service ps).
  2. Éteignez ce noeud (ou sudo docker node update --availability drain sur ce noeud depuis un gestionnaire).
  3. Rejouez service ps : la tâche renaît sur un autre noeud, sans que personne ne clique... et la boutique répond toujours, avec toutes ses données. C'est la réconciliation. Une fois le visualiseur de l'étape 06 en place, rejouez la scène en le regardant.
Ne drainez pas swarm-node04 : la base y est ancrée avec ses données, c'est le choix assumé du laboratoire (l'état s'ancre; la haute disponibilité des bases de données est l'affaire du module 2). Et si vous éteignez le gestionnaire chef (swarm-node01), vérifiez d'abord que les deux autres gestionnaires sont Reachable : ils éliront un nouveau chef. Avec un seul gestionnaire encore debout, plus de majorité : le cluster se fige.
Vous savez montrer : les cinq noeuds au node ls, le tableau de bord Traefik avec ses trois serveurs, la boutique Cornucopia répliquée qui répond avec ses articles et votre article illustré, et une tâche qui renaît ailleurs après la panne d'un noeud. C'est la démonstration attendue à l'évaluation.
06

Voir l'essaim : le visualiseur

Visualiseur

Déployer le visualiseur de Docker, un service de plus, ancré sur un gestionnaire, qui dessine les noeuds et leurs tâches en direct. C'est le conteneur Visualiseur du barème.

Pour mieux comprendre

Un service peut se créer sans pile, d'une seule commande docker service create : c'est exactement ce que stack deploy fait pour vous, service par service, en lisant le fichier YAML. Le visualiseur lit la socket Docker d'un gestionnaire, comme Traefik, et publie son port 8080 sur le port 5000 de l'essaim.

Démarche - depuis swarm-node01

swarm-node01 - le service viz
$ sudo docker service create \
  --name=viz \
  --publish=5000:8080/tcp \
  --constraint=node.role==manager \
  --mount=type=bind,src=/var/run/docker.sock,dst=/var/run/docker.sock \
  dockersamples/visualizer
$ sudo docker service ps viz -f "desired-state=Running"
ID             NAME     IMAGE                           NODE           DESIRED STATE   CURRENT STATE
k2p7v1qz0m4n   viz.1    dockersamples/visualizer:latest swarm-node01   Running         Running 40 seconds ago

Ce que dit la commande

  • --name=viz : le nom du service, celui qu'on retrouve au service ls.
  • --publish=5000:8080/tcp : le port 8080 du visualiseur publié sur le port 5000 de tous les noeuds, par le maillage de routage.
  • --constraint=node.role==manager : la même contrainte de placement que Traefik, écrite en ligne de commande au lieu du YAML.
  • --mount=type=bind,src=/var/run/docker.sock,... : la socket Docker, la fenêtre sur l'essaim.
  • dockersamples/visualizer : l'image officielle de démonstration de Docker.
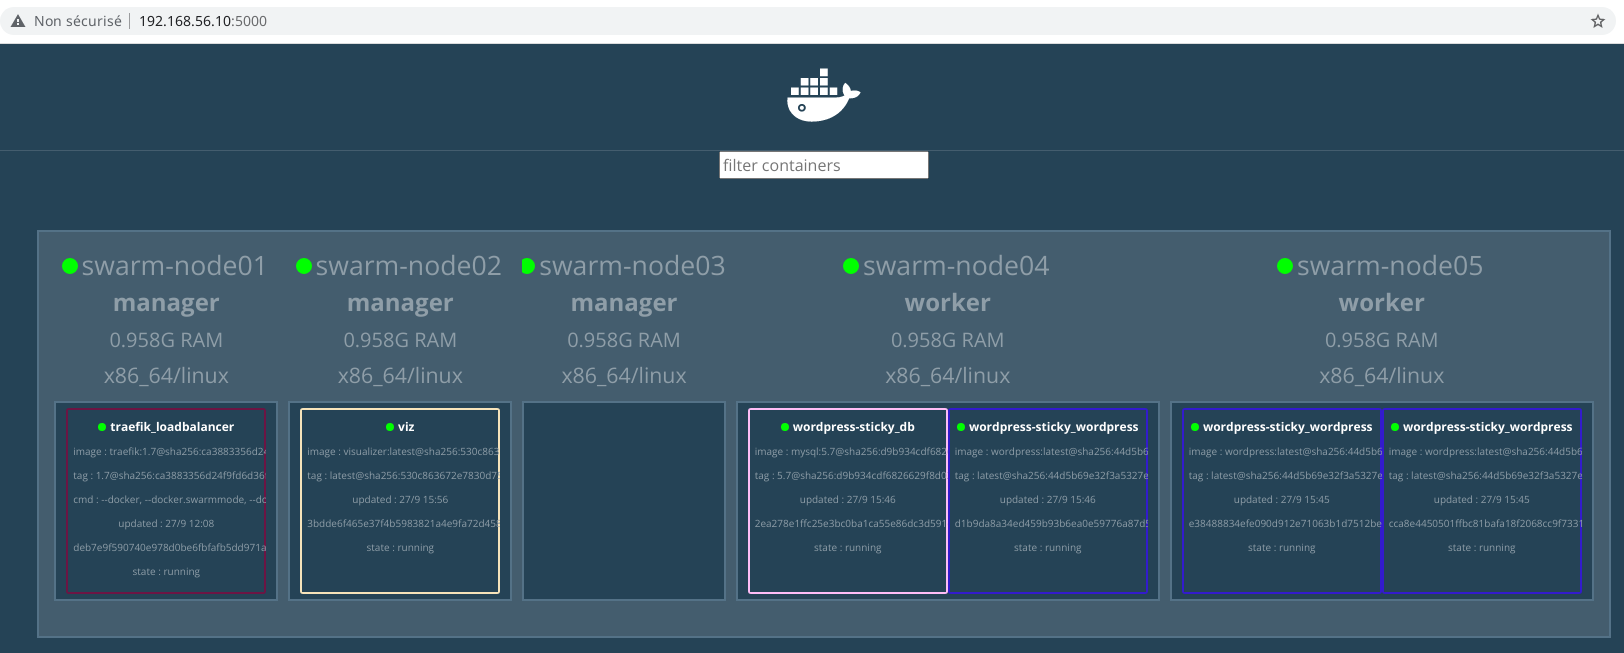
Le visualiseur sur http://192.168.56.10:5000 : les cinq noeuds et leurs tâches, Traefik et le visualiseur sur des gestionnaires, la base sur swarm-node04, les trois WordPress sur les travailleurs.

Rejouez maintenant la panne volontaire de l'étape 05 en gardant le visualiseur sous les yeux : la tâche disparaît d'un noeud et renaît sur l'autre, en direct.

http://192.168.56.10:5000 montre les cinq noeuds : traefik_loadbalancer et viz sur des gestionnaires, wordpress-sticky_db sur swarm-node04, les trois wordpress-sticky_wordpress sur swarm-node04 et 05. Avec Traefik, les trois WordPress, MySQL et le visualiseur, les cinq conteneurs du barème sont en place.

Défis facultatifs

Défi A - Passer à l'échelle

Montez le service WordPress à 4 répliques avec docker service scale, observez leur placement dans le visualiseur, puis redescendez à 2. L'essaim fait tout le travail.

Défi B - Sans le proxy

service ls montre WordPress publié sur le port 30000 du maillage de routage. Visitez http://192.168.56.40:30000 puis http://192.168.56.20:30000 : un noeud sans réplique répond quand même. Rechargez plusieurs fois et comparez avec le passage par Traefik : où sont passées les sessions persistantes ?

Défi C - L'essaim minimal

L'énoncé permet un essaim de trois noeuds : refaites le montage en 1 gestionnaire + 2 travailleurs sur l'infrastructure de votre choix (DinD, VirtualBox ou VPS) et notez ce qui change... et ce qui ne change pas.

Défi D - L'école d'horticulture

La sauvegarde contient formation/, une application Node.js autonome (node serveur.js, port 3081, aucune dépendance). Elle mérite son propre service : ajoutez-le à la pile (image node, montage du répertoire, contrainte de placement) et faites-le répondre sur son port publié. Sa route /sante vous dira si tout va bien.

Les fichiers complets

Pour vérifier votre travail ou repartir d'un bon pied : traefik.yml (étape 03) et wordpress-sticky.yml (étape 05), les deux piles telles que reproduites dans ce guide. La préparation des noeuds et de la sauvegarde (étapes 01, 02 et 04) reste à faire par vous.