Balancement de charge
& IP virtuelle
Découverte des concepts de haute disponibilité : de la répartition de charge jusqu'à la relève automatique avec Heartbeat.
420-5A4-MT · Module 2La quête de la haute disponibilité
Dans les systèmes modernes, un seul serveur n'est jamais suffisant. Face à la croissance du trafic ou au risque matériel, l'infrastructure doit s'adapter pour répartir l'effort et masquer les pannes.
- Première étape : répartir le travail sur plusieurs noeuds (Balancement de charge).
- Deuxième étape : protéger le point d'entrée pour qu'il ne devienne pas le nouveau talon d'Achille (IP virtuelle et Heartbeat).
Le balancement
de la charge
La répartition de charge : des algorithmes aux fermes de serveurs, jusqu'à HAProxy.
La répartition de charge
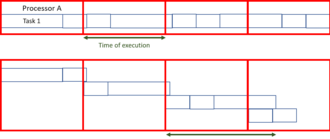
La répartition de charge (load balancing) désigne le processus de répartition d'un ensemble de tâches sur un ensemble de ressources, pour rendre le traitement global plus efficace : optimiser le temps de réponse de chaque tâche, tout en évitant de surcharger inégalement les noeuds. Très utilisée dans les services HTTP, où un site à forte audience gère des centaines de milliers de requêtes par seconde.
Spécifier un algorithme de répartition
Un algorithme de répartition répond toujours à un problème spécifique : la nature des tâches, la complexité qu'on s'autorise, l'architecture matérielle, la tolérance d'erreurs qu'on s'accorde. Un compromis pour répondre à un cahier des charges précis.
Plus on dispose d'information sur les tâches au moment de la décision, plus les possibilités d'optimisation sont grandes.
Les algorithmes statiques
Un algorithme est statique quand il ne tient pas compte de l'état du système (le niveau de charge des processeurs). On connaît le nombre de processeurs, leur puissance, les vitesses de communication - et on associe les tâches de façon à minimiser une fonction de performance. Toujours centralisé autour d'un organe qui distribue les charges.
Avantage : facile à mettre en place, et extrêmement efficace pour des tâches régulières - comme les requêtes HTTP d'un site. Mais une variance statistique subsiste : certaines unités peuvent se retrouver surchargées.
Les algorithmes dynamiques
Un algorithme est dynamique quand la charge de chaque noeud est prise en compte : les tâches peuvent se déplacer d'un noeud surchargé vers un noeud en sous-charge. Plus compliqué à mettre en place, mais d'excellents résultats quand le temps d'exécution varie fortement d'une tâche à l'autre.
Assignation unique (une fois, selon l'état du moment) ou dynamique (redistribution permanente). Attention aux coûts de communication : le pire des cas est une partie de ping-pong entre processeurs qui bloque tout.
Des machines de puissances différentes
Les infrastructures parallèles sont souvent composées de machines de puissances différentes - un paramètre à prendre en compte : les unités les plus faibles reçoivent en priorité les requêtes demandant moins de calcul, ou simplement moins de requêtes que les grosses unités.
Vous le vivrez au projet : vos machines virtuelles n'auront pas toutes la même puissance non plus.
Maître et travailleurs
Deux grandes catégories : les tâches attribuées par un « maître » et exécutées par des « travailleurs » qui le tiennent au courant (architecture « Master-Worker »), ou le contrôle distribué entre les noeuds - l'algorithme s'exécute sur chacun et la responsabilité est partagée (nécessairement dynamique).
Des stratégies intermédiaires existent (des maîtres par sous-grappe sous un maître global), mais elles deviennent vite complexes : les concepteurs préfèrent des algorithmes pilotables. Rappel : Swarm vous a déjà fait vivre le modèle gestionnaire-travailleurs !
La scalabilité de l'algorithme
Sur le long terme (serveurs, infonuagique), l'architecture évolue avec la demande - et on ne veut pas reconcevoir l'algorithme à chaque fois. Un algorithme est scalable quand ses performances restent relativement indépendantes de la taille du paramètre d'entrée.
Moulable : s'adapte à un nombre d'unités fixé avant l'exécution. Malléable : s'adapte en temps réel aux ressources disponibles. La plupart des algorithmes de répartition sont au moins moulables.
La tolérance d'erreurs
Dans les grands centres de calcul, il n'est pas envisageable qu'une exécution échoue à cause d'une panne d'une machine. Il faut détecter les dysfonctionnements, redistribuer la charge sur les unités fonctionnelles, et signaler la panne à la maintenance.
C'est exactement le programme de la semaine : l'entrée qui ne meurt pas.
Le cas idéal : la somme préfixale
Si les tâches sont indépendantes, divisibles, et de durée parfaitement connue : diviser le travail pour donner la même quantité de calcul à chacun, puis regrouper. Avec une somme préfixale, la répartition se calcule en temps logarithmique du nombre de processeurs. Si les tâches sont atomiques (indivisibles), on peut quand même approximer une répartition équitable.
En pratique, on ne connaît presque jamais le temps d'exécution à l'avance : cet algorithme sert surtout de référence théorique pour comparer les autres.
Sans connaissance préalable : Round-Robin
Quand le temps d'exécution est inconnu, la répartition statique reste possible. L'algorithme le plus simple : Round-Robin. La première requête au premier serveur, la suivante au deuxième, et ainsi de suite - puis on recommence au premier.
Version pondérée : les unités les plus puissantes reçoivent plus de requêtes, et les reçoivent en premier.
L'assignation aléatoire et les autres
Aléatoire : assigner les tâches au hasard donne d'assez bons résultats. Avec une permutation aléatoire calculée d'avance (ou une génération pseudo-aléatoire connue de tous), plus besoin de maître de distribution ni de communication.
- Moins de travail : davantage de tâches aux serveurs qui en exécutent le moins (pondérable).
- Hachage : répartition selon une table de hachage.
Les requêtes HTTP : la terminologie
Les requêtes HTTP forment le domaine d'application le plus répandu - et le plus abouti - de la répartition de charge.
Les algorithmes d'ordonnancement
Sur les répartiteurs courants, on peut pondérer chaque serveur indépendamment (ajouter un serveur plus ou moins puissant à la grappe après un pic), et choisir l'algorithme :
- Round-Robin et Round-Robin pondéré.
- Moins de connexions (pondéré ou non) : davantage de requêtes aux serveurs qui en traitent le moins.
- Hachage de destination : selon les adresses IP des serveurs.
- Hachage de source : selon l'adresse IP d'origine de la requête - le même client retombe toujours sur le même serveur.
NAT ou routage direct ?
- NAT (traduction d'adresse) : le répartiteur reçoit les requêtes, les renvoie aux serveurs en adresses privées, reçoit les réponses et les retransmet. Simple, mais TOUT le trafic passe par lui.
- Routage direct (DR) : les requêtes passent par le répartiteur, mais les serveurs répondent DIRECTEMENT au client. Plus d'adresses IP à mobiliser, mais le goulot d'étranglement disparaît - les réponses (pages, images, vidéos) sont bien plus grosses que les requêtes.
Et pour la panne du répartiteur lui-même : le protocole VRRP (Virtual Router Redundancy Protocol) gère la reprise - l'idée derrière notre IP virtuelle.
Les fermes de serveurs
Dans une ferme de serveurs (server cluster), un groupe de machines fonctionne comme UN dispositif unique : reliées entre elles, elles exécutent un logiciel qui contrôle leur activité et leur disponibilité. Les informations de disponibilité remontent à un serveur maître qui distribue les tâches aux machines les plus disponibles.
Les institutions favorisent les fermes pour les applications Internet : haute disponibilité et scalabilité élevée - la croissance se prend en charge par l'ajout de matériel. C'est ce qui a permis aux services des années 1990 de servir des millions d'utilisateurs de façon sûre, fiable et rapide.
La mise en oeuvre
La répartition distribue n'importe quel service entre différents ordinateurs et emplacements : serveurs web, accès VPN, proxys, pare-feu. Une première technique : faire correspondre le nom du serveur à plusieurs machines en modifiant les tables DNS - mais le DNS ne connaît ni la disponibilité ni les pannes : des requêtes partent vers des serveurs occupés à 100 % ou morts.
Le dispositif de répartition règle ces deux problèmes : il ne distribue qu'aux serveurs disponibles.
Le répartiteur simule un serveur
Le répartiteur peut être un routeur, un commutateur, un système d'exploitation ou un logiciel. Les clients communiquent avec lui comme s'il était le serveur : il transmet les demandes, reçoit les réponses et les renvoie au client en se faisant passer pour le serveur. Cas particulier : un achat sécurisé peut imposer que les demandes suivantes du même acheteur aillent au même serveur.
Les machines de la ferme doivent accéder au même lot de fichiers : système de fichiers distribué ou réseau de stockage (SAN). Et les sessions ne peuvent pas être vérifiées par un seul serveur - plusieurs peuvent servir la même session.
HAProxy
HAProxy est un logiciel libre et gratuit : un répartiteur de charge à haute disponibilité et un serveur proxy pour les applications TCP et HTTP. Écrit en C, il a la réputation d'être rapide et efficace en processeur comme en mémoire.
Utilisé par GoDaddy, GitHub, Bitbucket, Stack Overflow, Reddit, Slack, Speedtest.net, Tumblr, Twitter, et dans le produit OpsWorks d'Amazon Web Services. C'est LUI que vous installez cette semaine.
Les caractéristiques de HAProxy
- Balancement couche 4 (TCP) et couche 7 (HTTP)
- Persistance multi-facteurs (stickiness)
- Réécriture d'URL
- Limitation de débit
- Terminaison SSL/TLS
- Compression Gzip
- Cache
- Protocole PROXY
- Vérifications de santé scriptables multi-couches
- Journalisation des connexions et messages HTTP
- HTTP/2 des deux côtés
- WebSocket
- Balancement et relais Syslog UDP/TCP
- Architecture multi-fils pilotée par événements
- Rechargements sans coupure (hitless)
- Support gRPC, Lua et SPOE
- API
- Réessais couches 4 et 7
- Coupe-circuit simplifié
- Débogage et traçage avancés
- Tables distribuées pour statistiques et mitigation de déni de service
Haute disponibilité :
IP virtuelle et Heartbeat
L'adresse qui n'appartient à personne et que le cluster se passe de main en main quand une machine meurt.
La haute disponibilité
La haute disponibilité (high availability, HA) désigne une architecture ou un service dont le taux de disponibilité est convenable. C'est un enjeu majeur des infrastructures : l'indisponibilité est critique - pensez à l'arrêt d'une chaîne de production.
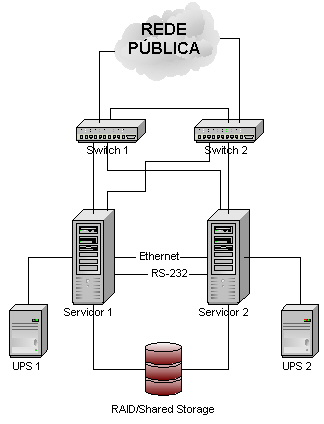
- Une infrastructure matérielle spécialisée, basée sur la redondance : le cluster de haute disponibilité (par opposition au cluster de calcul), une grappe dont le but est d'éviter au maximum les indisponibilités.
- Des processus adaptés pour réduire les erreurs et accélérer la reprise (ITIL en contient plusieurs).
Heartbeat et l'IP virtuelle
Heartbeat (LinuxHA) met plusieurs serveurs Linux en cluster pour le fail-over (la tolérance de panne) : un serveur « passif » (esclave) attend, prêt à prendre le relais du serveur « actif » (maître) si celui-ci tombe en panne ou cesse de fournir le service.
Le principe : le cluster détient une IP « virtuelle » par laquelle les clients passent, plutôt que par l'IP d'un serveur en particulier. Heartbeat achemine les communications vers le serveur actif s'il est vivant - et vers le passif le cas échéant. Le battement de coeur qui décide qui porte l'adresse.